
Spark 核心之 YARN-Client 模式:原理、流程与源码级深度拆解
摘要:YARN-Client 是生产环境中使用最广泛的 Spark 部署模式。它的独特之处在于——Driver 运行在提交客户端,而 ApplicationMaster 退化为轻量级的 ExecutorLauncher,仅负责向 ResourceManager 申请 Container 启动 Executor。本文从 YARN 架构模型、AM 特殊角色、12 步启动流程、与 Standalone 对比四个维度,配合 2 张原创深色架构图 + 完整代码示例,带你彻底吃透 YARN-Client 模式的每一个细节。
关键词:Spark on YARN, YARN-Client, ResourceManager, ApplicationMaster, NodeManager, Container, ExecutorLauncher, Hadoop
一、开篇:为什么 YARN 是生产环境的首选?
前两篇文章我们分别深度拆解了 Standalone-Client 和 Standalone-Cluster 模式。但在实际生产环境中,绝大多数 Spark 集群都运行在 YARN 之上,而非 Spark 自带的 Standalone 模式。
原因很直接:
Standalone          YARN
──────────          ────
Spark 专有            Hadoop 生态标准
无细粒度资源隔离       Container 级别的 CPU/内存隔离
不支持多租户           YARN Queue 天然多租户
独立集群管理           与 HDFS / Hive / HBase 统一调度
用一句话概括:
Standalone 是 Spark 的入门模式,YARN 是 Spark 的生产模式。
而我们今天要讲的 YARN-Client 模式,是 YARN 上最常用于交互式查询和开发调试的模式。它的核心设计思想与 Standalone-Client 如出一辙——Driver 在客户端运行,但底层资源调度完全由 YARN 负责。
二、YARN 架构基础
2.1 YARN 四大角色
理解 YARN-Client 之前,必须理解 YARN 的基础架构:
| 角色 | 职责 | 对应 Standalone |
|---|---|---|
| ResourceManager (RM) | 全局资源管理与调度 | ≈ Spark Master |
| NodeManager (NM) | 单节点资源监控与 Container 管理 | ≈ Spark Worker |
| ApplicationMaster (AM) | 单个应用的生命周期管理 | 无直接对应 🔑 |
| Container | 抽象资源容器(CPU + 内存) | ≈ Executor |
2.2 YARN-Client 模式核心特征
图 1:Spark on YARN-Client 模式整体架构
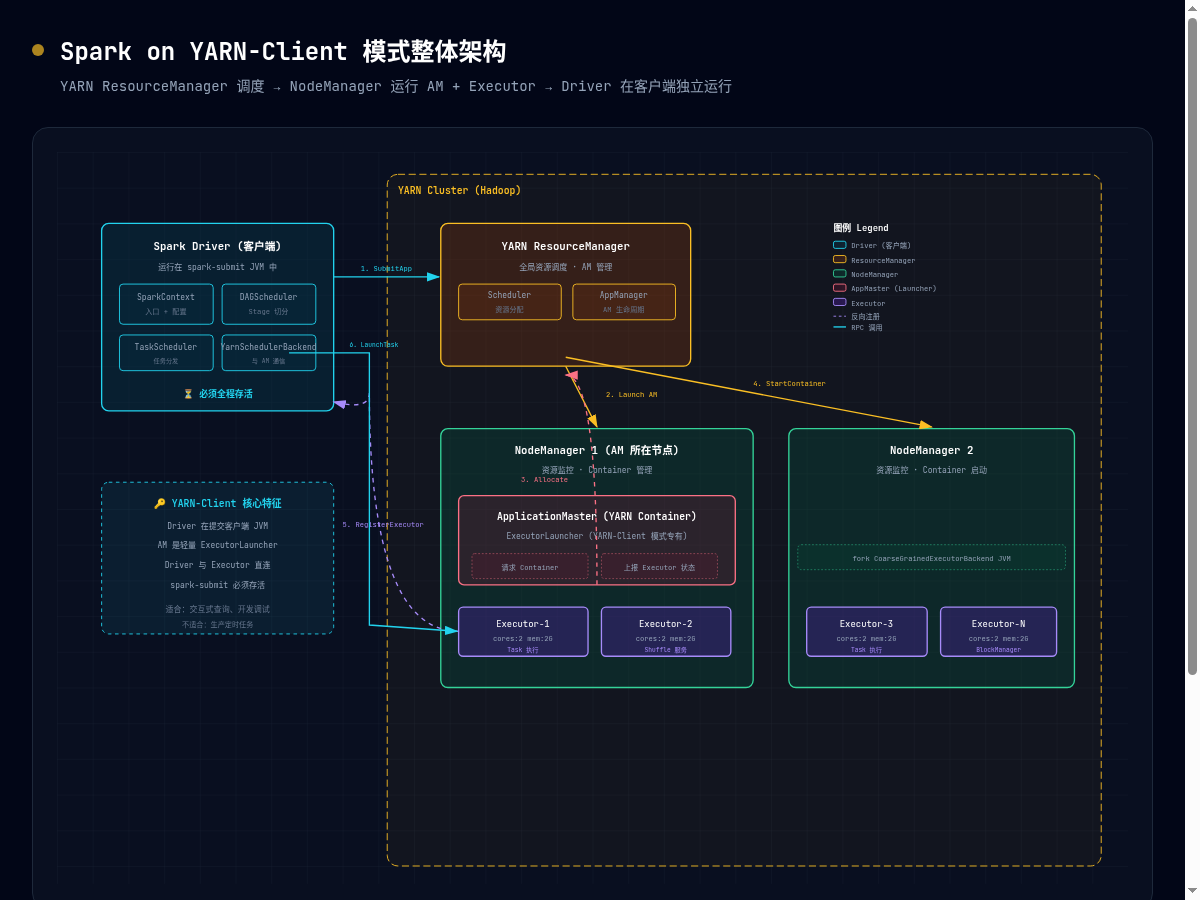
三条核心设计原则:
Driver 在客户端,AM 是轻量 ExecutorLauncher:Driver 不做任何 YARN 资源协商——这一切由 AM(ExecutorLauncher)代理完成。AM 的职责非常单一:向 RM 申请 Container、通知 NM 启动 Executor、把 Executor 信息反馈给 Driver。
Driver 与 Executor 直连通信:Executor 在 NM 分配的 Container 中启动后,直接向客户端 Driver 反向注册,与 Standalone 模式一致。RM 和 NM 不参与 Task 调度。
spark-submit 必须存活:这是 YARN-Client 的"阿喀琉斯之踵"。Driver 在客户端,客户端退出 = 整个应用死亡。
三、YARN-Client vs YARN-Cluster:一张表彻底搞清
| 对比维度 | YARN-Client | YARN-Cluster |
|---|---|---|
| Driver 位置 | 提交客户端 JVM | AM 所在 Container 内 |
| AM 角色 | ExecutorLauncher(轻量,仅负责资源申请) | Spark 完整 Driver + 资源申请 |
| spark-submit 生命周期 | 必须全程存活 | 提交后可退出 |
| 日志查看 | 控制台直接可见 | yarn logs -applicationId <appId> |
| 适用场景 | spark-shell / 交互式 / 开发调试 | 生产定时任务 |
| 网络要求 | Driver ↔ Executor 互通 | 集群内部闭环 |
四、YARN-Client 启动流程:12 步深度拆解 🔥
图 2:YARN-Client 模式启动流程消息时序图(12 步 × 6 Phase)
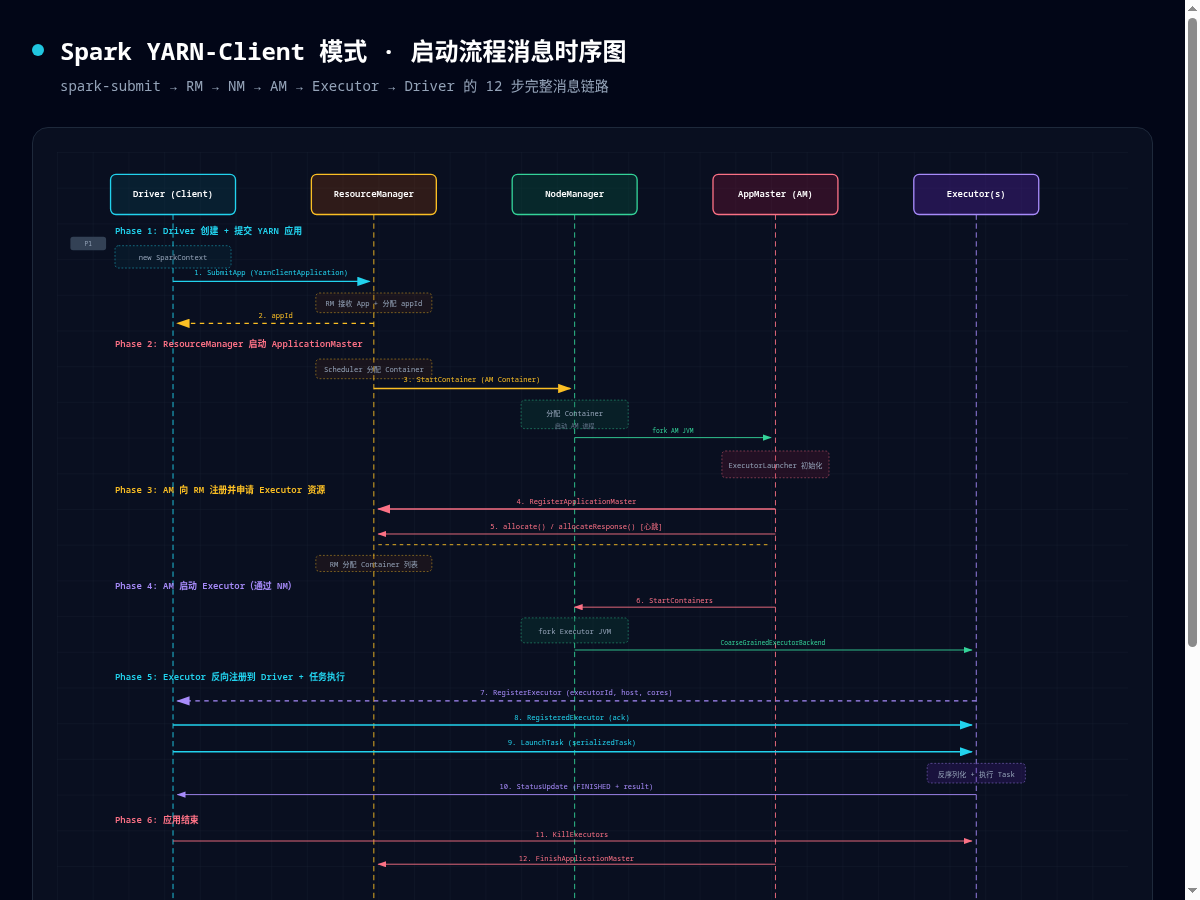
4.1 Phase 1:Driver 初始化 + 向 RM 提交应用
Step 1-2:
spark-submit \
  --master yarn \
  --deploy-mode client \
  --executor-memory 4G \
  --num-executors 8 \
my-app.jar执行流程:SparkSubmit 判断 master == "yarn" && deployMode == "client" → 在当前 JVM 创建 SparkContext → 初始化 YarnSchedulerBackend → 创建 YarnClient → 向 RM 提交 YarnClientApplication → RM 返回 appId。
// 源码:YarnClientImpl.java
public YarnClientApplication createApplication() {
  ApplicationSubmissionContext appContext =
    Records.newRecord(ApplicationSubmissionContext.class);
  GetNewApplicationResponse newApp =
    rmClient.getNewApplication();
  // ...
  return new YarnClientApplication(newApp, appContext);
}
4.2 Phase 2:RM 调度 + NM 启动 ApplicationMaster
Step 3: RM 的 Scheduler 为 AM 分配一个 Container → 向 NM 发送 StartContainer。
Step 4: NM 接收指令后分配 Container 资源 → fork 新的 JVM 进程运行 ApplicationMaster。
# NM 内部等价命令
java org.apache.spark.deploy.yarn.ApplicationMaster \
  --class <user-main-class> \
  --jar <user-jar> \
  1><stdout> 2><stderr>
YARN-Client 模式的关键:这里的 AM 不是完整的 Driver,而是 ExecutorLauncher——一个只负责申请 Executor 资源的轻量级代理。
// 源码:ApplicationMaster.scala
// YARN-Client 模式下的 AM 入口
if (isClusterMode) {
  runDriver()  // YARN-Cluster: 启动完整 Driver
} else {
  runExecutorLauncher()  // YARN-Client: 仅启动资源申请代理
}
4.3 Phase 3:AM 注册 + 循环申请 Container
Step 5: AM 向 RM 发送 RegisterApplicationMaster 注册自己。
Step 6: AM 进入心跳循环,通过 allocate() 不断向 RM 请求 Container:
// AM 心跳循环(简化)
while (!finished) {
  val response = rmClient.allocate(progress)
  // 处理 RM 分配的 Container
  for (container <- response.getAllocatedContainers) {
    // 在对应 NM 上启动 Executor
    startExecutorOnNodeManager(container)
  }
  Thread.sleep(spark.yarn.scheduler.heartbeat.interval) // 默认 3s
}
RM 分批返回 Container 列表——YARN 的资源分配是渐进式的,不像 Standalone 一次性分配全部 Executor。
4.4 Phase 4-6:后续流程
Executor 在 Container 中启动 → 反向注册到客户端 Driver → Driver 发送 Task → 应用结束 → AM 发送 FinishApplicationMaster → RM 回收全部 Container。
与 Standalone 模式的关键区别:资源回收由 RM 统一管理,无需 Driver 逐一向 Master 注销。
五、YARN 三种部署模式全景对比
| 维度 | Standalone-Client | Standalone-Cluster | YARN-Client | YARN-Cluster |
|---|---|---|---|---|
| 资源管理 | Spark Master | Spark Master | YARN RM | YARN RM |
| Driver 位置 | 客户端 | Worker 节点 | 客户端 | AM Container |
| AM 角色 | 无 | 无 | ExecutorLauncher | 完整 Driver |
| 资源隔离 | 无 | 无 | Container 级别 | Container 级别 |
| 多租户 | ❌ | ❌ | ✅ YARN Queue | ✅ YARN Queue |
| 生产推荐 | 开发调试 | 中小规模 | 交互式生产 | 大规模定时任务 |
六、生产环境最佳实践
6.1 关键配置
spark-submit \
  --master yarn \
  --deploy-mode client \
  # Executor 配置
  --executor-memory 4G \
  --executor-cores 2 \
  --num-executors 8 \
  # Driver 配置(影响本地 JVM!)
  --driver-memory 4G \
  # YARN 特有配置
  --conf spark.yarn.am.memory=1G \        # AM 内存
  --conf spark.yarn.am.cores=1 \          # AM 核心数
  --conf spark.yarn.queue=default \       # YARN Queue
  --conf spark.yarn.maxAppAttempts=2 \    # AM 重试次数
  my-app.jar
6.2 常见故障排查
故障 1:AM 启动超时
ERROR: ApplicationMaster failed to start within 600 seconds解决:增大 AM 超时时间和内存
--conf spark.yarn.am.waitTime=1200s
--conf spark.yarn.am.memory=2G
故障 2:Executor 无法反向注册到 Driver
ERROR CoarseGrainedExecutorBackend: Cannot register with driver根因:Executor 所在的 NM 节点无法访问客户端 Driver 的 IP。YARN-Client 模式要求 Driver 主机对集群内所有 NM 可达。
解决:
# 显式指定 Driver Host(多网卡机器)
--conf spark.driver.host=<公网或集群内 IP>
--conf spark.driver.port=<固定端口>
故障 3:Container 内存超限被 YARN Kill
Container killed by YARN for exceeding memory limits解决:YARN 的内存限制比 Spark 更严格——spark.executor.memory 必须小于 NM 可用内存,且需要留出 overhead。
七、总结
核心知识速记
| 要点 | 一句话总结 |
|---|---|
| Driver 位置 | YARN-Client:提交客户端;YARN-Cluster:AM Container 内 |
| AM 角色 | YARN-Client 的 AM 是轻量 ExecutorLauncher,不做 DAG 解析 |
| 资源协商 | AM 通过 allocate/allocateResponse 心跳循环向 RM 申请 Container |
| 与 Standalone 差异 | YARN 提供 Container 级资源隔离 + 多租户 Queue |
| 生产推荐 | 交互式用 YARN-Client,定时任务用 YARN-Cluster |
| 运维优势 | 统一 Hadoop 生态管理,日志聚合、资源隔离开箱即用 |
金句:在 YARN-Client 模式下,Driver 是你手中的风筝,AM 是你在集群中的信使——它替你与 YARN 谈判资源,而你只需专注于业务逻辑。