
Spark 核心之 Driver 原理剖析
摘要:如果把 Spark 应用比作一个人,Driver 就是它的大脑。从 spark-submit 敲下回车的那一刻起,SparkContext 初始化、DAGScheduler 切分 Stage、TaskScheduler 分发 Task、SchedulerBackend 与集群通信、SparkEnv 管理运行时环境——所有这些都在 Driver 内部精密协作。本文从 Driver 内部架构全景、SparkContext 初始化链路、三大调度器协作模型、SparkEnv 七大组件、Driver 生命周期六个维度,配合 1 张原创深色架构图和完整源码级分析,带你彻底看清 Driver 的内部世界。
关键词:Spark Driver, SparkContext, DAGScheduler, TaskScheduler, SchedulerBackend, SparkEnv, BlockManager, Driver 生命周期
一、开篇:Driver 是什么?
先回答一个面试高频题:
"Spark Driver 到底做了什么?"
答案不是一句话能说完的。Driver 是 Spark 应用的总控制器,它承载了至少以下七大职责:
| # | 职责 | 核心组件 |
|---|---|---|
| 1 | 解析用户代码 → 构建 DAG | DAGScheduler |
| 2 | 将 DAG 切分为 Stage | DAGScheduler |
| 3 | 将 Stage 拆分为 Task 并分发 | TaskSchedulerImpl |
| 4 | 与集群通信(申请/释放资源) | SchedulerBackend |
| 5 | 管理运行时环境(内存/序列化/Shuffle) | SparkEnv |
| 6 | 事件监听与 Web UI | LiveListenerBus + SparkUI |
| 7 | Executor 心跳监控 | HeartbeatReceiver |
二、Driver 内部架构全景图
图 1:Spark Driver 内部架构全景图
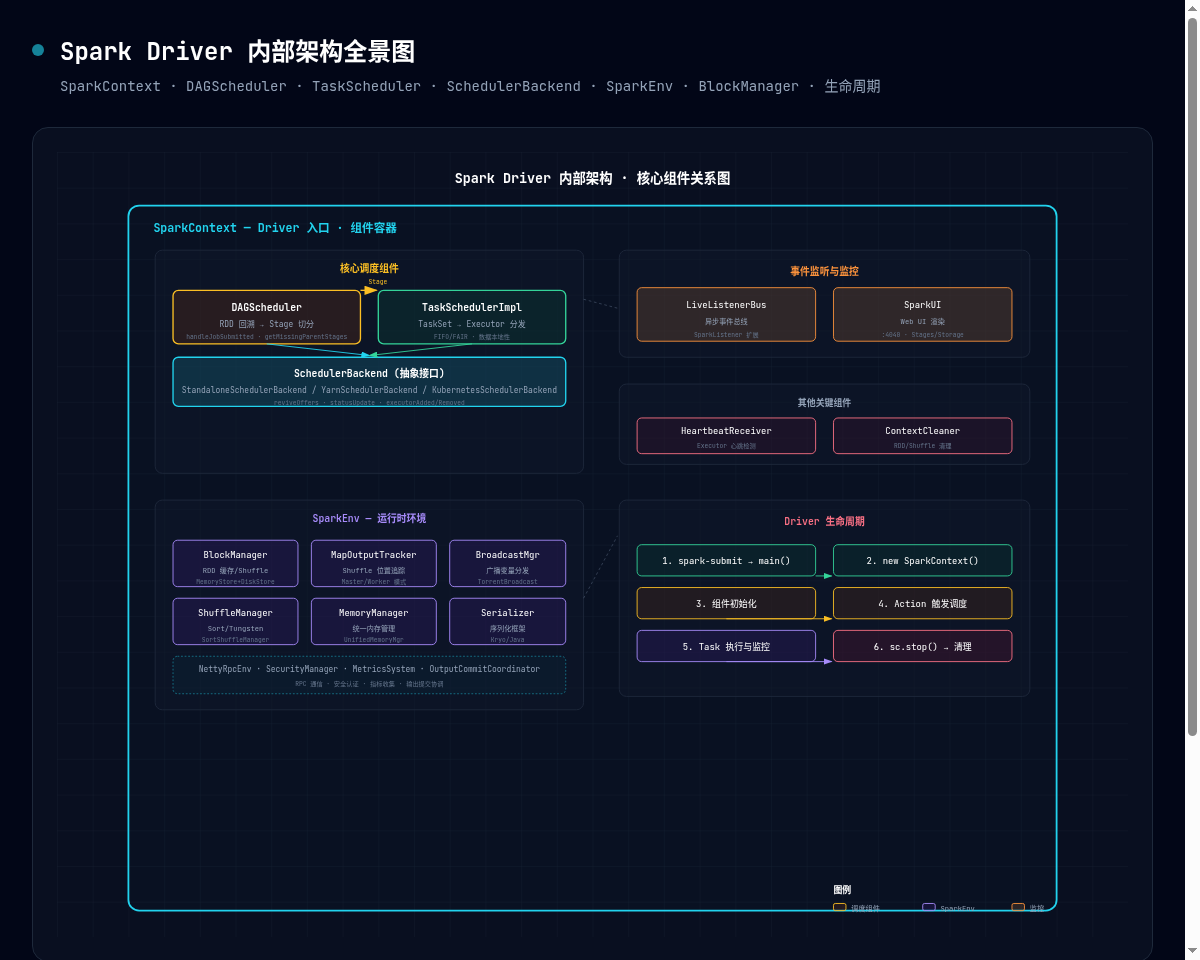
2.1 三大组件群
┌─────────────────────────────────────────────────┐
│                  SparkContext                    │
│  ┌─────────────┐  ┌─────────────┐  ┌──────────┐│
│  │核心调度组件  │  │  SparkEnv   │  │ 监控/事件 ││
│  │DAGScheduler │  │BlockManager │  │LiveListen ││
│  │TaskScheduler│  │ShuffleMgr   │  │SparkUI    ││
│  │SchedulerBknd│  │MemoryMgr    │  │MetricsSys ││
│  └─────────────┘  └─────────────┘  └──────────┘│
└─────────────────────────────────────────────────┘
三、SparkContext 初始化链路
这是 Driver 启动最核心的代码路径。
scala
// 源码:SparkContext.scala (简化版初始化链路)
class SparkContext(config: SparkConf) extends Logging {
  // Step 1: 创建 SparkEnv(运行时环境)
  private var _env: SparkEnv = _
  _env = SparkEnv.createDriverEnv(conf, isLocal, listenerBus, ...)

  // Step 2: 创建元数据追踪器
  _applicationId = _env.conf.get("spark.app.id")
  _dagScheduler = new DAGScheduler(this)

  // Step 3: 创建 TaskScheduler + SchedulerBackend
  val (sched, ts) = SparkContext.createTaskScheduler(this, master, deployMode)
  _schedulerBackend = sched
  _taskScheduler = ts

  // Step 4: DAGScheduler 绑定 TaskScheduler
  _dagScheduler = new DAGScheduler(this)
  _taskScheduler.start()

  // Step 5: 启动心跳接收器
  _heartbeatReceiver = env.rpcEnv.setupEndpoint(
    HeartbeatReceiver.ENDPOINT_NAME, new HeartbeatReceiver(this))

  // Step 6: 注册 SparkListener + 启动 WebUI
  setupAndStartListenerBus()
  _ui = SparkUI.create(conf, listenerBus, _env, ...)
}
四、三大调度器协作模型 🔥
这是 Driver 最核心的调度链路。
用户代码 (Action)
  │
  ▼
DAGScheduler.handleJobSubmitted()
  │  ① 回溯 RDD 依赖 → 创建 ResultStage
  │  ② getMissingParentStages() → 递归构建 ShuffleMapStage
  │  ③ submitMissingTasks() → 为每个 Partition 创建 Task
  ▼
TaskScheduler.submitTasks(taskSet)
  │  ④ TaskSetManager 封装 → 数据本地性排序
  │  ⑤ reviveOffers() → 通知 Backend 有 Task 可调度
  ▼
SchedulerBackend.reviveOffers()
  │  ⑥ makeOffers() → 匹配空闲 Executor 与 Task
  │  ⑦ launchTasks() → 序列化 Task 发送给 Executor
  ▼
Executor (远程 JVM)
     ⑧ 反序列化 → 执行 → 序列化结果 → StatusUpdate
4.1 DAGScheduler:Stage 切分核心
scala
// 源码核心逻辑
private def submitStage(stage: Stage): Unit = {
  val missing = getMissingParentStages(stage).sortBy(_.id)
  if (missing.isEmpty) {
    submitMissingTasks(stage, jobId.get)
  } else {
    for (parent <- missing) submitStage(parent)
  }
}

private def getMissingParentStages(stage: Stage): List[Stage] = {
  stage.rdd.dependencies.flatMap {
    case shufDep: ShuffleDependency[_, _, _] =>
      getOrCreateShuffleMapStage(shufDep, stage.firstJobId)
    case _ => Nil // NarrowDep 不切分
  }.toList
}
规则:遇到 ShuffleDependency 即切分 Stage。
4.2 TaskSchedulerImpl:数据本地性
scala
// 数据本地性优先级
PROCESS_LOCAL > NODE_LOCAL > RACK_LOCAL > ANY
// 每个级别等待 spark.locality.wait (默认 3s)
4.3 SchedulerBackend:集群通信适配器
| 实现 | 通信目标 |
|---|---|
| StandaloneSchedulerBackend | Spark Master (Netty RPC) |
| YarnSchedulerBackend | YARN AM → RM (Hadoop RPC) |
| KubernetesClusterSchedulerBackend | K8s API Server (HTTP REST) |
五、SparkEnv:运行时环境七大组件
scala
// 源码:SparkEnv.createDriverEnv()
val blockManager = new BlockManager(...)
val broadcastManager = new BroadcastManager(...)
val mapOutputTracker = new MapOutputTrackerMaster(...)
val shuffleManager = SortShuffleManager(conf)
val memoryManager = UnifiedMemoryManager(conf, ...)
val serializer = new JavaSerializer(conf) // or KryoSerializer
val closureSerializer = new JavaSerializer(conf)| 组件 | 职责 |
|---|---|
| BlockManager | RDD 缓存(Memory + Disk)、Shuffle 数据存储 |
| MapOutputTracker | 追踪 Shuffle Map 输出位置(Master/Worker) |
| ShuffleManager | SortShuffleManager 管理 Shuffle 写/读 |
| MemoryManager | UnifiedMemoryManager:执行 + 存储统一内存池 |
| Serializer | Task 序列化/反序列化 |
| BroadcastManager | TorrentBroadcast 分布式广播 |
| RpcEnv | NettyRpcEnv:Driver ↔ Executor 通信基础设施 |
六、Driver 完整生命周期
Phase 1: spark-submit → main() → new SparkContext()
   ├── 创建 SparkEnv(运行时环境)
   ├── 创建 DAGScheduler + TaskScheduler + SchedulerBackend
   ├── 向 Master/RM 注册,申请 Executor
   └── 启动 HeartbeatReceiver + SparkUI

Phase 2: Action 触发 → DAG 调度
   ├── DAGScheduler.handleJobSubmitted()
   ├── Stage 切分 + Task 生成
   ├── TaskScheduler 分发 Task
   └── Executor 执行 + StatusUpdate 回传

Phase 3: 监控与运维
   ├── LiveListenerBus 推送事件
   ├── SparkUI :4040 实时监控
   └── HeartbeatReceiver 心跳检测

Phase 4: sc.stop() → 优雅退出
   ├── 通知 SchedulerBackend 停止
   ├── Kill 全部 Executor
   ├── 向 Master/RM 注销
   └── 释放 SparkEnv 资源
七、Driver 配置调优
bash
spark-submit \
  --driver-memory 4G \           # Driver JVM 堆内存
  --driver-cores 2 \             # Driver 可用核心
  --conf spark.driver.maxResultSize=2G \  # collect() 结果上限
  --conf spark.driver.extraJavaOptions="-XX:+UseG1GC" \
  --conf spark.driver.extraClassPath=/path/to/extra.jar \
  --conf spark.driver.supervise=true \  # Standalone Cluster 专属
  my-app.jar
八、总结
| 要点 | 总结 |
|---|---|
| Driver 本质 | 用户 main() 运行的 JVM 进程,SparkContext 即 Driver 入口 |
| 三大调度器 | DAGScheduler → TaskScheduler → SchedulerBackend 逐层下发 |
| SparkEnv | 7 大组件提供序列化、Shuffle、内存、存储等运行时能力 |
| 生命周期 | 初始化 → 调度循环 → 监控 → 优雅退出 |
金句:Executor 是 Spark 的四肢,Driver 是 Spark 的大脑——DAGScheduler 思考"如何拆分",TaskScheduler 决定"派给谁",SchedulerBackend 负责"怎么送"。