
Spark 核心之 Spark-WebUI 详解及日志查看
摘要:Spark Web UI 是监控、调试和性能调优的核心入口。本文从架构全景出发,逐一详解 7 大核心 Tab(Jobs/Stages/Storage/Executors/Environment/SQL/Streaming)的使用方法和指标含义,深入 History Server 的 EventLog 重放机制、log4j 日志体系配置、YARN/K8s 容器日志查看,配合 2 张架构图 + 超实用命令速查表,助你成为 Spark 排错高手。
关键词:Spark WebUI, History Server, EventLog, log4j, Jobs/Stages/Executors Tab, yarn logs, Spark 监控, 性能调优
一、开篇:4040 端口背后的秘密
每个 Spark 应用启动后,都会在日志中看到:
SparkUI: Bound SparkUI to 0.0.0.0, and started at http://host:4040这行信息背后是一个完整的监控体系:
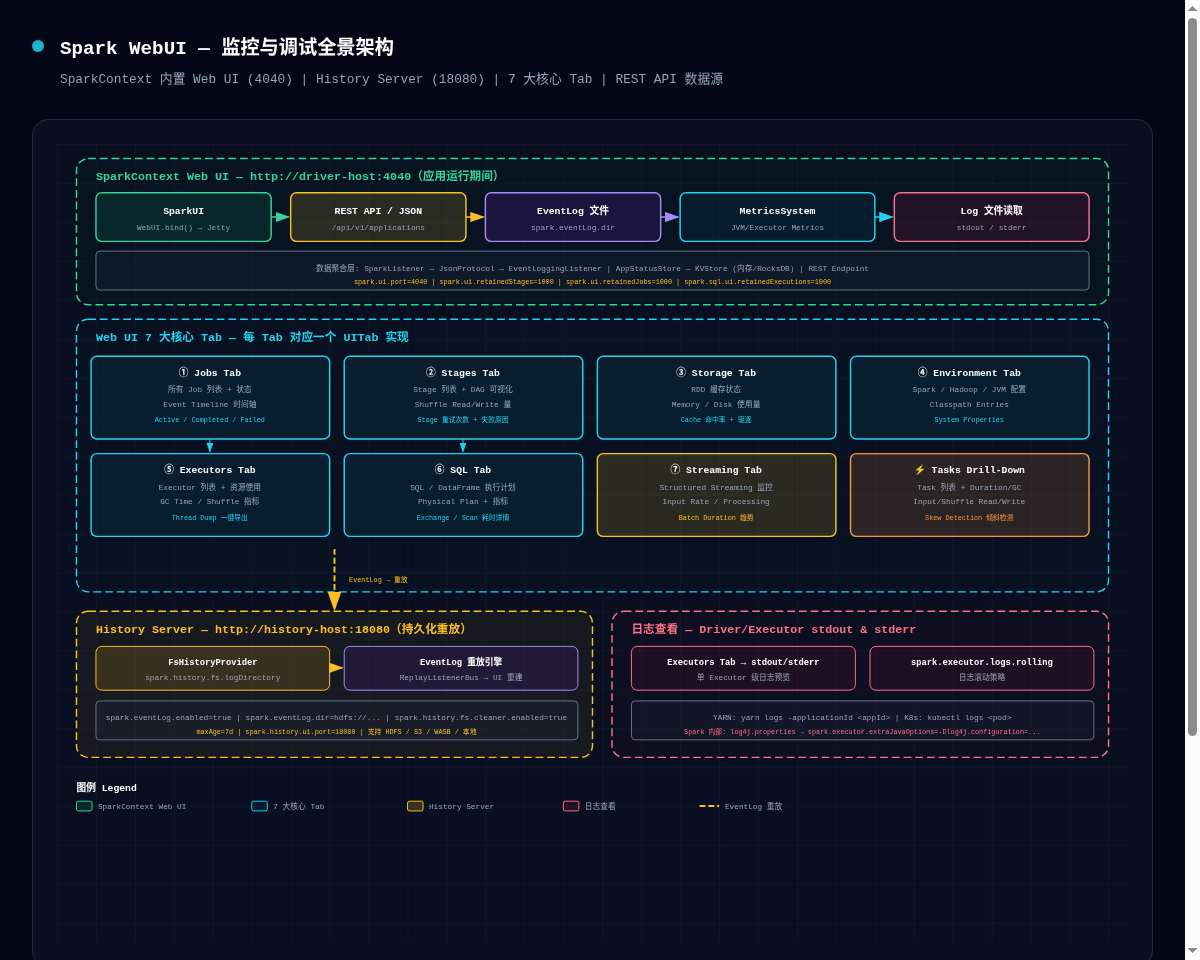
Spark Web UI 体系
├── 运行时 Web UI:     http://driver-host:4040          (应用存活时)
├── History Server:    http://history-host:18080        (跨应用历史)
├── REST API:          http://host:4040/api/v1/...       (JSON 接口)
├── EventLog:          spark.eventLog.dir (HDFS/S3/本地) (持久化)
└── MetricsSystem:     JVM / Executor Metrics             (指标收集)
核心配置
# spark-defaults.conf — Web UI 核心参数
spark.ui.port=4040
spark.ui.retainedJobs=1000         # 保留 Job 数量
spark.ui.retainedStages=1000       # 保留 Stage 数量
spark.ui.retainedTasks=100000      # 保留 Task 数量
spark.ui.timeline.tasks.maximum=1000
spark.sql.ui.retainedExecutions=1000
spark.ui.reverseProxy=true         # 反向代理支持
二、WebUI 架构全景
图 1:Spark WebUI 监控与调试全景架构 — 4040 UI + 7 Tab + 18080 History Server
三、7 大核心 Tab 逐个详解
3.1 ① Jobs Tab — 全局 Job 视图
每个 Spark Action 触发一个 Job。Jobs Tab 列出所有 Job 的状态、Duration、Stage 数量和 Event Timeline 时间轴。
Jobs Tab 关键指标
├── Duration:   Job 总耗时(含调度等待)
├── Stages:     成功 / 失败 / 跳过(因结果已缓存)
├── Tasks:      总数(所有 Stage 的 Task 数之和)
└── Event Timeline:  Executor 加入/移除、Job 起止时间轴
3.2 ② Stages Tab — DAG 分段监控 🔍
点击任一 Stage 进入详情页,可以看到该 Stage 下所有 Task 的执行明细:
Stage Detail — 调优重点区域
├── Summary Metrics: Duration / Input Size / Shuffle Read/Write
├── Aggregated Metrics by Executor:          (每个 Executor 的聚合)
├── Tasks 列表: Duration / GC Time / Shuffle Read Write
├── DAG Visualization:                        Stage DAG 图
└── Event Timeline: Task 执行时间轴【检测数据倾斜!】数据倾斜检测:如果 Max Duration >> Median,说明存在数据倾斜。
3.3 ③ Storage Tab — RDD 缓存状态
显示所有被 cache() 或 persist() 的 RDD/DataFrame 的缓存状态:
Storage Tab 关注点
├── Cache 命中率 < 100%  →  数据量 > 总缓存空间
├── Size on Disk > 0    →  内存不足,已溢写磁盘
└── Fraction Cached < 1 →  部分 Partition 未被缓存
3.4 ④ Executors Tab — 资源与性能 ⚡
最重要的性能诊断 Tab,展示每个 Executor 的:
Executors Tab — 关键指标
├── RDD Blocks:         内存中缓存的数据块数
├── Storage Memory:      已用 / 总存储内存
├── Task Time:           GC Time + Non-GC Task Time
├── Shuffle Read/Write:  跨Executor 数据传输量
├── Input / Output:      从外部源读取/写入量
├── Thread Dump:         Executor JVM 线程快照
└── stdout / stderr:     Executor 级日志直接查看
3.5 ⑤ Environment Tab — 运行环境
全量展示 Spark / Hadoop / JVM 配置。排查"为什么 spark.sql.shuffle.partitions 没生效"时来这里确认实际生效值。同时显示 Classpath Entries 和 System Properties。
3.6 ⑥ SQL Tab — DataFrame/SQL 执行计划
SQL Tab — 每个 Query 的详细信息
├── Logical Plan:        逻辑执行计划
├── Physical Plan:       物理执行计划
├── WholeStageCodegen:   是否走全阶段代码生成
├── Exchange (Shuffle):  数据量 + Partition 数
├── Scan:                读取行数 + 数据量
└── Duration 分解:       每个算子耗时占比
四、EventLog 与 History Server
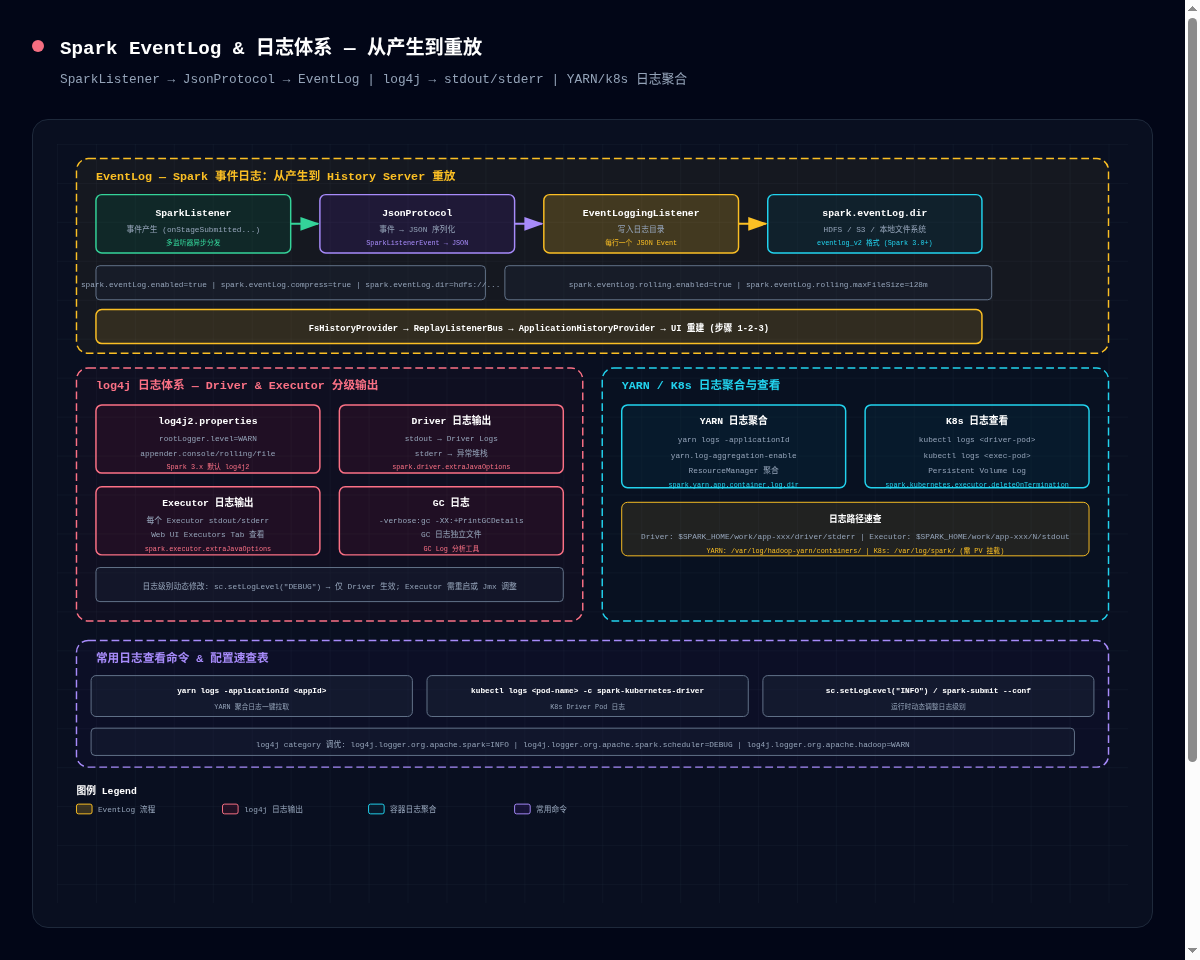
图 2:Spark EventLog + log4j 日志体系 — 从事件产生到 History Server 重放
4.1 EventLog 配置
# spark-defaults.conf — EventLog 必备配置
spark.eventLog.enabled=true
spark.eventLog.dir=hdfs://namenode:8020/spark-history
spark.eventLog.compress=true          # 压缩节省 60-80% 空间
spark.eventLog.rolling.enabled=true   # 大日志文件滚动
spark.eventLog.rolling.maxFileSize=128m

# History Server 配置
spark.history.fs.logDirectory=hdfs://namenode:8020/spark-history
spark.history.ui.port=18080
spark.history.fs.cleaner.enabled=true
spark.history.fs.cleaner.maxAge=7d    # 只保留 7 天
4.2 启动 History Server
# 方式一:独立启动
$SPARK_HOME/sbin/start-history-server.sh

# 方式二:指定配置文件和目录
$SPARK_HOME/sbin/start-history-server.sh \
  --properties-file /etc/spark/conf/history.properties \
  hdfs://namenode:8020/spark-history
4.3 REST API 直接查询
# 查询应用列表
curl http://history-host:18080/api/v1/applications

# 查询具体应用 Job 列表
curl http://history-host:18080/api/v1/applications/{appId}/jobs

# 查询 Stage 详情
curl http://history-host:18080/api/v1/applications/{appId}/stages/{stageId}
五、log4j 日志体系
5.1 日志级别动态调整
// ① 代码中动态调整(仅 Driver 端)
spark.sparkContext.setLogLevel("DEBUG")
// 可选: ALL, DEBUG, INFO, WARN, ERROR, FATAL, OFF# ② spark-submit 传入(Driver + Executor)
--conf "spark.driver.extraJavaOptions=-Dlog4j.configuration=file:log4j.properties"
--conf "spark.executor.extraJavaOptions=-Dlog4j.configuration=file:log4j.properties"5.2 log4j2.properties 模板(Spark 3.x)
# $SPARK_HOME/conf/log4j2.properties
rootLogger.level=WARN
rootLogger.appenderRef.stdout.ref=console

# 关键包日志调整
logger.spark.name=org.apache.spark
logger.spark.level=INFO

logger.scheduler.name=org.apache.spark.scheduler
logger.scheduler.level=DEBUG          # 查看 Task 调度细节

logger.hadoop.name=org.apache.hadoop
logger.hadoop.level=WARN              # Hadoop 太吵了
5.3 YARN / K8s 日志查看
# === YARN ===
yarn logs -applicationId application_1234567890_0001
yarn logs -applicationId app_xxx -containerId container_xxx
yarn logs -applicationId app_xxx -logFiles stdout

# === Kubernetes ===
kubectl logs <driver-pod> -c spark-kubernetes-driver
kubectl logs <executor-pod> -c executor
kubectl exec <driver-pod> -- ls /var/log/spark/
六、实战排查三场景
场景一:Task 数据倾斜检测
诊断路径:
  Stage Detail → Tasks Duration (Max vs Median)
  Max Duration >> Median → 数据倾斜!
  → 查看 Shuffle Read Size 分布
  → 方案: 加盐 / 两阶段聚合 / Broadcast Join
场景二:GC 时间过高
诊断路径:
  Executors Tab → GC Time 列
  GC Time > Task Time 的 10% → GC 压力过大
  → 增大 executor memory 或堆外内存
  → 调整 GC 策略(G1GC / ParallelGC)
  → 启用 GC 日志: -verbose:gc -XX:+PrintGCDetails
场景三:Shuffle 数据量异常
诊断路径:
  SQL Tab → Exchange → 检查数据量和 Partition 数
  Shuffle Write >> 合理范围 → 检查是否有不必要的 Shuffle
  → 检查 spark.sql.shuffle.partitions 是否过小
  → 使用 Broadcast Hint 避免 Shuffle
七、总结
运行时 Web UI (4040):Jobs → Stages → Tasks 自上而下定位瓶颈;Executors Tab 查看资源与 GC;SQL Tab 检查物理计划算子耗时。
History Server (18080):通过 EventLog 重放已结束应用,支持跨应用对比。必备配置
spark.eventLog.enabled=true。日志体系:log4j 分级控制 +
sc.setLogLevel()动态调整 +yarn logs/kubectl logs查看容器日志。三大实战场景:Task 倾斜(Duration Max vs Median)、GC 压力(GC Time > 10%)、Shuffle 异常(Exchange 数据量分析)。
作者:starzy
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践