
SparkSQL 之 over 函数:窗口规范与六个生产场景
摘要:离线数仓里,"每个类目销售额前三的商品""用户最长连续登录天数""环比增长率"这类需求,用 groupBy 往往要写多层自连接。窗口函数一条 SQL 就能解决。这篇文章梳理 over 子句的窗口规范,用六个真实场景把 ROW_NUMBER、LAG、SUM/AVG OVER 的写法和坑讲清楚。
关键词:窗口函数, OVER, ROW_NUMBER, LAG, 累计求和, 连续登录, TopN
一、先搞清楚:窗口函数解决什么问题
做订单分析时,常有这种需求:既要每个订单的明细,又要在每一行上算"这个用户到目前为止累计消费了多少"。
用 groupBy 会折叠行,拿到的是每个用户一个汇总值,明细就丢了;想同时保留明细和汇总,只能把聚合结果 join 回原表。窗口函数的价值就在这里——它在一行上算一个基于"窗口"(一组相关行)的聚合值,但不折叠任何一行。
语法骨架:
FUNC(col) OVER (
  PARTITION BY key          -- 分区:按 key 分组,组内独立计算
  ORDER BY sort_col         -- 排序:决定窗口内行的先后
  ROWS/RANGE BETWEEN ...    -- 帧边界:滑动窗口范围(可选)
)
FUNC 分三类:排名(ROW_NUMBER / RANK / DENSE_RANK)、偏移(LAG / LEAD)、聚合(SUM / AVG / COUNT / MIN / MAX 加 OVER)。
二、两个最容易被搞混的点
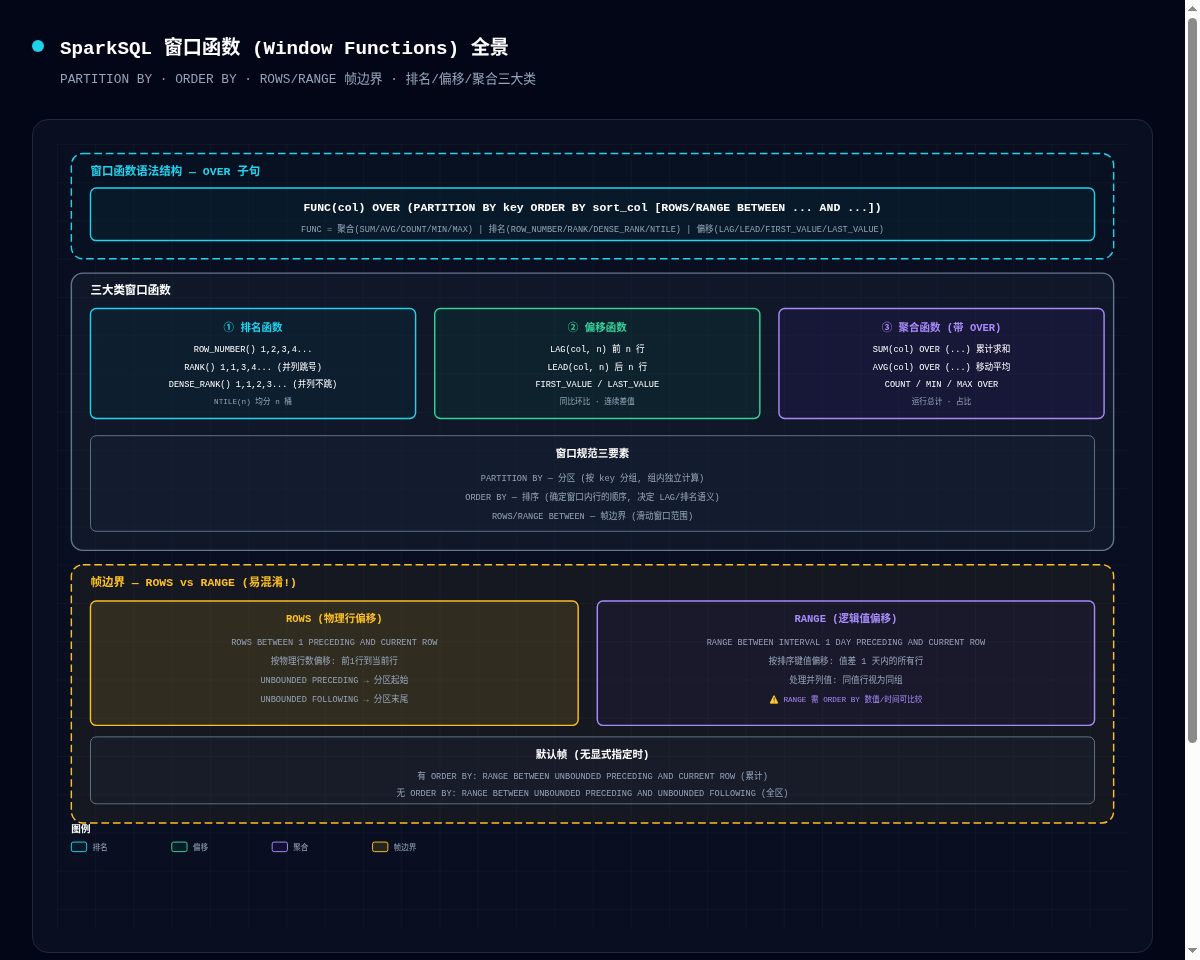
2.1 ROWS 与 RANGE 的区别
这是窗口函数里最容易写错的地方。差别在于"滑动窗口怎么界定":
-- ROWS:按物理行数偏移
ROWS BETWEEN 1 PRECEDING AND CURRENT ROW
--   当前行往上数 1 行,就是窗口(不管值是否相等)

-- RANGE:按排序键的值偏移
RANGE BETWEEN 1 PRECEDING AND CURRENT ROW
--   ORDER BY 列的值在 [当前值-1, 当前值] 的所有行
一句话:ROWS 数的是行,RANGE 数的是值。RANGE 要求 ORDER BY 的列是数值或日期,否则没法做"值减 1"这种运算。
2.2 默认帧的坑
不写 ROWS/RANGE 时,Spark 的默认帧取决于有没有 ORDER BY:
-- 有 ORDER BY:默认是累计
-- RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
SUM(amount) OVER (PARTITION BY uid ORDER BY dt)   -- 逐行累计

-- 无 ORDER BY:默认是全区
SUM(amount) OVER (PARTITION BY uid)               -- 每行都是该 uid 的总和
这一点在写 SUM OVER 累计时不用显式声明,但心里要清楚默认行为,否则改个排序方向结果就变了。
三、六个生产场景
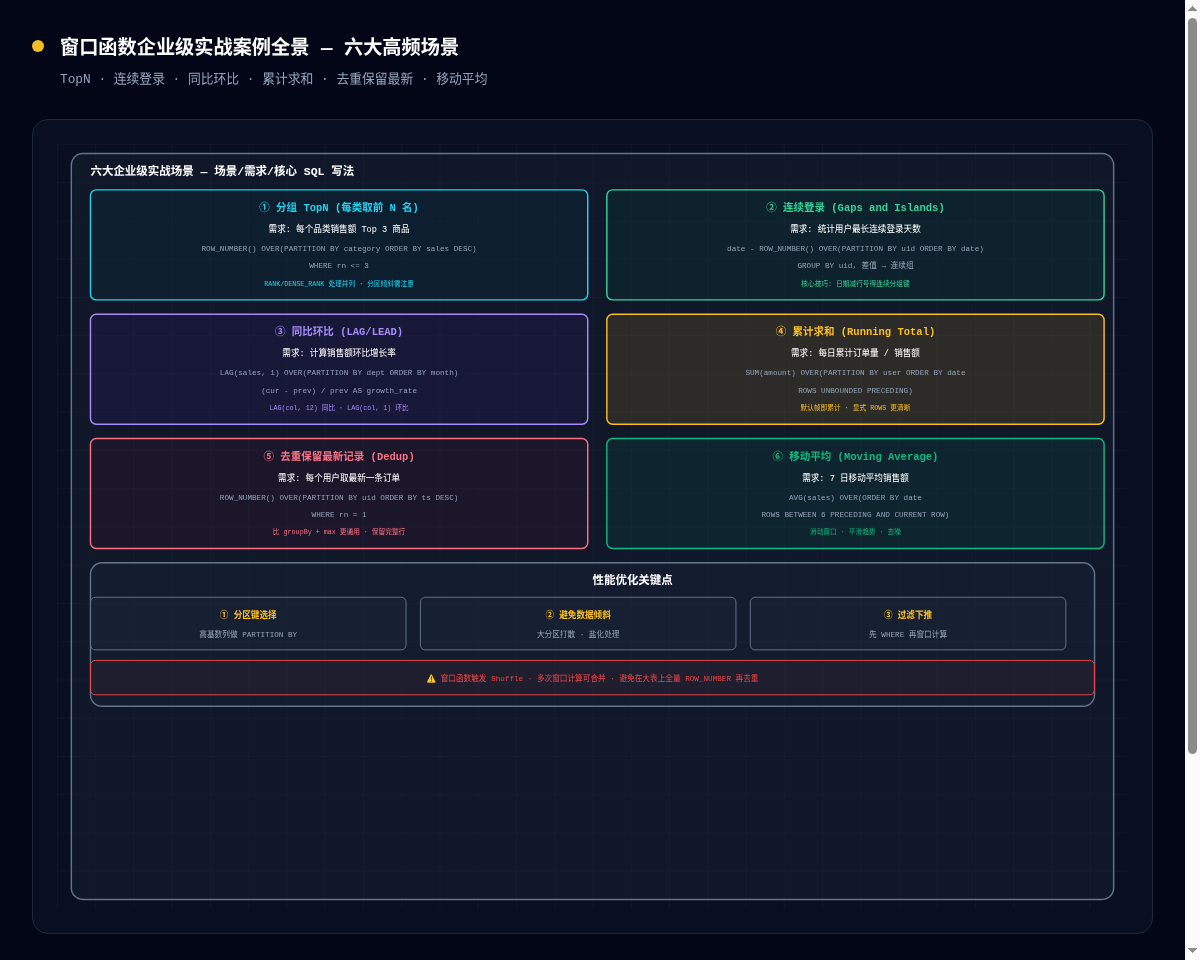
下面是数仓里真正高频的六类需求,每个都给出能直接跑的 SQL 和踩坑点。
场景一:每个类目销售额 Top 3 商品
需求:电商报表里最经典的 TopN,每个 category 取 sales 最高的 3 个商品。
SELECT category, product_id, sales
FROM (
  SELECT category, product_id, sales,
    ROW_NUMBER() OVER (PARTITION BY category ORDER BY sales DESC) AS rn
  FROM product_sales
) t
WHERE rn <= 3;两个坑:
- 并列怎么处理?ROW_NUMBER 会给并列值随机分配一个唯一序号,可能漏掉本来并列第三的商品。如果业务要求"并列都保留",用
DENSE_RANK()(1,1,2,3 不跳号),把rn <= 3换成rank <= 3。 - 分区倾斜。某个 category 有上亿行时,这一个分区会拖垮整个 job。应对办法见第四节。
场景二:用户最长连续登录天数
需求:留存分析里统计每个用户连续登录的最长天数。这是经典的 Gaps and Islands 问题。
核心思路:连续日期的特点是"日期递增 1,行号也递增 1",所以 日期 - 行号 是个常量,能标识一段连续区间。
SELECT uid, MAX(days) AS max_consecutive_days
FROM (
  SELECT uid, grp, COUNT(*) AS days
  FROM (
    SELECT uid, login_date,
      DATE_SUB(login_date, ROW_NUMBER() OVER (PARTITION BY uid ORDER BY login_date)) AS grp
    FROM (
      SELECT DISTINCT uid, login_date FROM user_login
    ) dedup
  ) grouped
  GROUP BY uid, grp
) agg
GROUP BY uid;两个坑:
- 必须先去重。一个用户同一天登录多次,不去重的话
日期-行号会被打乱,连续判断直接失效。上面用SELECT DISTINCT uid, login_date先干掉重复。 DATE_SUB(date, n)在 SparkSQL 里是date - n 天,第二个参数是 ROW_NUMBER 返回的整数,类型对得上才能减。
场景三:环比 / 同比增长率
需求:每个部门月度销售额的环比增长率。
SELECT dept, month, sales,
  LAG(sales, 1) OVER (PARTITION BY dept ORDER BY month) AS prev_sales,
  ROUND(
    (sales - LAG(sales, 1) OVER (PARTITION BY dept ORDER BY month)) * 100.0
    / LAG(sales, 1) OVER (PARTITION BY dept ORDER BY month),
    2
  ) AS growth_pct
FROM dept_sales_monthly;两个坑:
- LAG 的默认值。每个分区第一行没有"上一行",
LAG(sales, 1)返回 NULL,NULL 参与除法会让整行 growth 变成 NULL。给第三个参数一个默认值:LAG(sales, 1, 0),或者用CASE WHEN显式处理第一行。 - 环比是
LAG(..., 1),同比(去年同期)是LAG(..., 12),按月粒度。别把偏移量写反。
场景四:累计求和(Running Total)
需求:每个用户按时间累计消费金额,常用于等级、额度计算。
SELECT uid, order_date, amount,
  SUM(amount) OVER (
    PARTITION BY uid
    ORDER BY order_date
    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
  ) AS cumulative_amount
FROM orders;
这里显式写 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW 是防御性写法——虽然它是默认帧,但显式声明能让读代码的人一眼看清"这是累计",不用去回忆默认行为。
场景五:每个用户取最新一条记录(去重)
需求:用户表有历史变更流水,要每个 uid 的最新一条。
SELECT uid, order_id, amount, ts
FROM (
  SELECT uid, order_id, amount, ts,
    ROW_NUMBER() OVER (PARTITION BY uid ORDER BY ts DESC) AS rn
  FROM order_log
) t
WHERE rn = 1;
和 groupBy(uid) + max(ts) 相比,窗口函数能保留整行,不需要再 join 一次把最新记录的其它字段取回来。这是它在这个场景下的核心价值。
场景六:7 日移动平均
需求:销量趋势图里平滑毛刺,算 7 日移动平均。
SELECT dt, sales,
  AVG(sales) OVER (
    ORDER BY dt
    ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
  ) AS ma7
FROM daily_sales;
注意:这里没写 PARTITION BY,是全量单序列的移动平均。如果按商品分别算,补上 PARTITION BY product_id。窗口范围是"当前行 + 前 6 行 = 7 天",所以是 6 PRECEDING,别写成 7 PRECEDING。
四、性能与踩坑
窗口函数会触发 Shuffle(按 PARTITION BY 的 key 重分布),代价不低。生产上留意几点:
- 分区键选高基数列。PARTITION BY 的列基数太小(比如性别、布尔值),数据会挤进少数几个分区,退化成单点计算。
- 先过滤再开窗。WHERE 能下推就下推,先把数据量压下去,再算窗口,别在大表上直接开窗再过滤。
- 避免全量 ROW_NUMBER 再去重。如果只是要"每类最大的一个",
groupBy + max更便宜;ROW_NUMBER 全量排序的代价要高一个量级。 - 并列名次要谨慎。业务口径是"取前 N 名"还是"取前 N 行",决定了用 DENSE_RANK 还是 ROW_NUMBER,这在数仓里常出数据不一致的事故。
五、总结
- 窗口函数的本质是聚合但不折叠行,需要"明细 + 汇总"同时出现的场景优先考虑。
- 排名用 ROW_NUMBER(唯一)还是 DENSE_RANK(并列保留),取决于业务口径,这是最容易埋数据口径坑的地方。
- 写 SUM/AVG OVER 时心里明确默认帧是"累计",需要滑动窗口就显式写 ROWS/RANGE。
- 连续登录、去重保留最新这两个场景,窗口函数比 groupBy + join 更简洁也更省一次 Shuffle。
作者:大数据技术实践者
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践