
Spark 核心之 DAG 有向无环图原理分析
摘要:你是否注意过 Spark UI 上的 "DAG Visualization" 图?那个有向无环图(DAG)不是凭空生成的——它是 Spark 从你写的每一行 RDD Transformation 中逐条构建的"血缘图谱"。本文从 RDD DAG 的构建过程、DAGScheduler 如何将 RDD DAG 转换为 Stage DAG、Lineage 容错机制、Checkpoint 截断血缘、Spark UI DAG 可视化五个维度,配合 1 张原创深色架构图 + 源码分析,带你彻底理解 Spark DAG 的原理与价值。
关键词:Spark DAG, RDD Lineage, 惰性求值, Stage DAG, DAGScheduler, Checkpoint, 血缘容错
一、开篇:DAG 是什么?
RDD DAG(有向无环图)= RDD 的血缘图谱(Lineage Graph)
  ├── 顶点(Vertex)= 每个 RDD
  ├── 边(Edge)= 父 RDD 到子 RDD 的 Dependency
  ├── 方向:父 → 子(数据流向)
└── 无环:不存在循环依赖(RDD 是不可变的)核心特性:DAG 是惰性构建的——每写一行 map/filter/reduceByKey,就在 DAG 上加一个节点,但不执行任何计算。只有 Action 算子才触发 DAGScheduler 将 RDD DAG 转换为 Stage DAG 并执行。
二、RDD DAG → Stage DAG 全景图
图 1:Spark DAG 原理 — RDD DAG → Stage DAG 转换
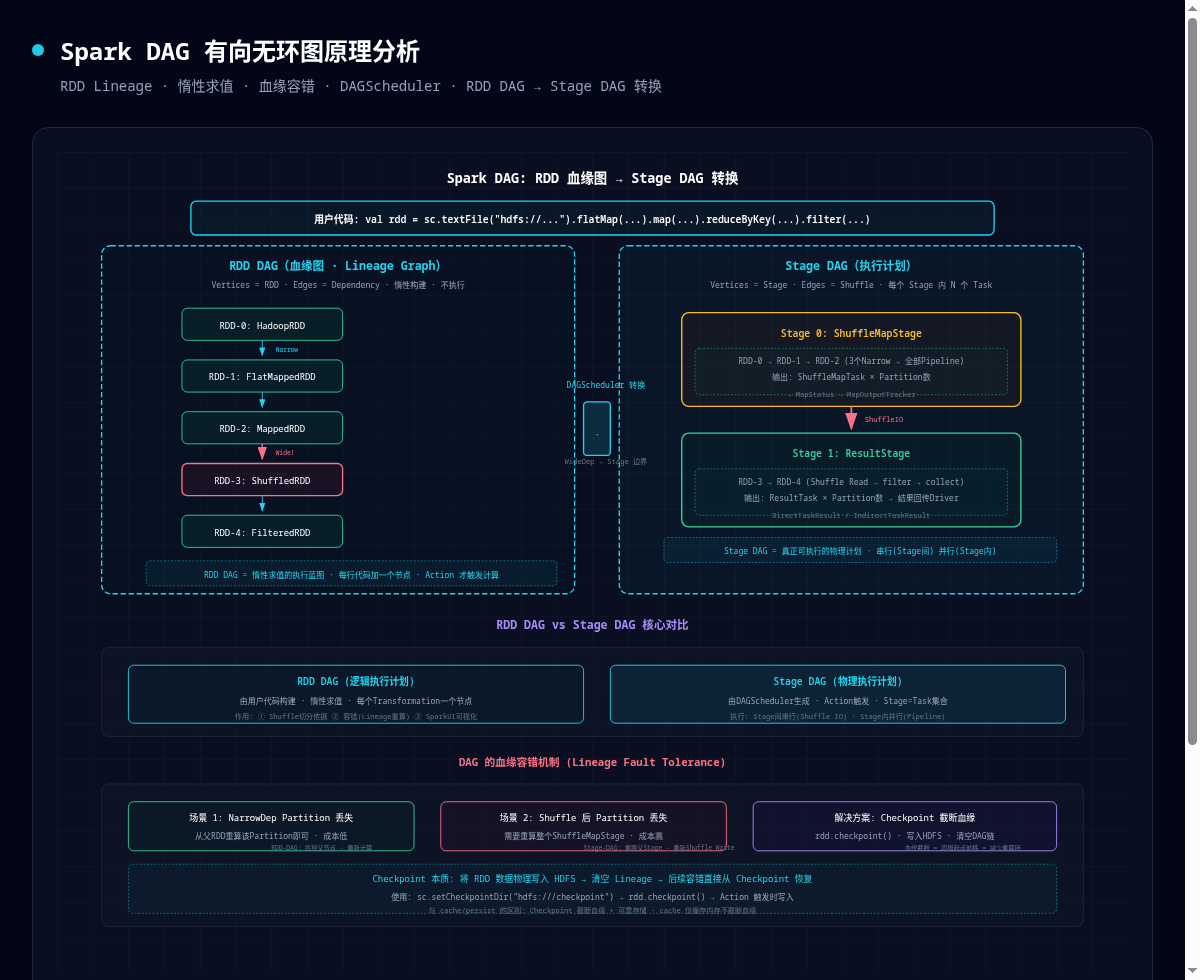
三、RDD DAG 的构建:每行代码一个节点
scala
// 每行 Transformation 往 DAG 加一个 RDD 节点
val rdd0 = sc.textFile("hdfs://...")       // RDD-0: HadoopRDD
val rdd1 = rdd0.flatMap(_.split(" "))      // RDD-1: FlatMappedRDD — NarrowDep → RDD-0
val rdd2 = rdd1.map((_, 1))                // RDD-2: MappedRDD — NarrowDep → RDD-1
val rdd3 = rdd2.reduceByKey(_ + _)         // RDD-3: ShuffledRDD — WideDep → RDD-2
val rdd4 = rdd3.filter(_._2 > 10)          // RDD-4: FilteredRDD — NarrowDep → RDD-3
// ↑ 此时 DAG 已构建完毕,但没有任何计算发生(惰性求值)

rdd4.collect()  // ← Action 触发 → DAGScheduler 将 RDD DAG 转为 Stage DAG
3.1 惰性求值的价值
Transformation → 只记录操作(构建 DAG),不执行
Action        → 触发 DAGScheduler.runJob() → 转换 Stage DAG → 执行
惰性求值让 Spark 有机会在运行前优化整个计算链——函数组合(Pipeline)、谓词下推、列裁剪等。
四、DAGScheduler 转换:RDD DAG → Stage DAG
scala
// 源码:DAGScheduler.createResultStage()
private def createResultStage(finalRDD: RDD[_], ...): ResultStage = {
  // 从 finalRDD 回溯依赖链 → 遇 ShuffleDep → 创建 ShuffleMapStage
  val parents = getOrCreateParentStages(finalRDD, jobId)
  new ResultStage(id, finalRDD, func, partitions, parents, jobId, ...)
}

// 转换规则
// NarrowDep (RDD1→RDD2) → 同 Stage(不切分)
// ShuffleDep (RDD2→RDD3) → Stage 边界!创建新 Stage转换结果:
Stage 0 (ShuffleMapStage): RDD-0 → RDD-1 → RDD-2 (3个Narrow, Pipeline)
Stage 1 (ResultStage):     RDD-3 → RDD-4 (Shuffle Read → filter → collect)
五、DAG 的血缘容错
scala
// RDD 的血缘信息(每个 RDD 都有)
abstract class RDD[T] {
  // 依赖列表(指向父 RDD)
  def dependencies: Seq[Dependency[_]]

  // 计算函数(如何处理父 RDD 的 Partition)
  def compute(split: Partition, context: TaskContext): Iterator[T]

  // 容错:从 Lineage 重新计算丢失 Partition
  def getOrCompute(partition: Partition, context: TaskContext): Iterator[T]
}| 丢失场景 | 容错方式 | 成本 |
|---|---|---|
| NarrowDep Partition | 从父RDD重算该Partition | 低(Narrow链内重算) |
| Shuffle后Partition | 重算整个ShuffleMapStage | 高(全量Shuffle重做) |
Checkpoint 截断:rdd.checkpoint() 将数据写入 HDFS → 清空 Lineage → 容错起点前移。
bash
sc.setCheckpointDir("hdfs:///spark-checkpoint")
// ... transformations ...
rdd.checkpoint()  # 标记 Checkpoint
rdd.collect()     # Action 触发时写入 HDFS + 清空 Lineage
六、RDD DAG vs Stage DAG 对比
| 维度 | RDD DAG | Stage DAG |
|---|---|---|
| 构建时机 | Transformation 代码写一行加一个节点 | Action 触发时由 DAGScheduler 生成 |
| 节点类型 | RDD(HadoopRDD/MappedRDD...) | Stage(ShuffleMapStage/ResultStage) |
| 边类型 | NarrowDep / ShuffleDep | Shuffle(只有 Wide 边界) |
| 是否可执行 | ❌(惰性蓝图) | ✅(物理执行计划) |
| 可见位置 | Spark UI → "DAG Visualization" | Spark UI → "Stages" 页签 |
七、总结
| 要点 | 总结 |
|---|---|
| DAG 本质 | RDD Lineage 图,惰性构建,Action 才转换执行 |
| 转换 | DAGScheduler 遇 ShuffleDep 切分 → RDD DAG → Stage DAG |
| 容错 | Narrow 轻量重算 · Wide 成本高 · Checkpoint 截断血缘 |
| 价值 | 优化 Pipeline + 容错 Lineage + 可视化执行计划 |
金句:DAG 是 Spark 的"施工蓝图"——Transformation 是在蓝图上画线,Action 是按蓝图施工。蓝图可以回退(容错重算),也可以截断存档(Checkpoint)。