
Spark 核心之 Worker 原理剖析
摘要:Spark Worker 是 Standalone 集群中每台节点上的"大管家"。它负责向 Master 注册签到、每 15 秒发送心跳、接收 Master 指令 fork Executor 和 DriverWrapper 进程、实时追踪本节点的 CPU/内存资源余量、并在进程退出时回收资源。但 Worker 有一个"反直觉"的特点——它完全不参与 Task 调度。本文从 Worker 内部架构全景、核心数据结构、进程 fork 管理、资源追踪模型、完整生命周期五个维度,配合 1 张原创深色架构图 + 完整源码分析,带你彻底看清 Worker 的内部世界。
关键词:Spark Worker, ProcessBuilder, CoarseGrainedExecutorBackend, coresFree, LaunchExecutor, 心跳, 资源管理
一、开篇:Worker 是什么?
如果 Master 是集群的"指挥中心",Worker 就是每台节点上的"执行总管"。
| 职责 | 说明 |
|---|---|
| 向 Master 注册 | 启动时上报 host/port/cores/memory |
| 心跳上报 | 每 15 秒告知 Master 自己还活着 |
| fork 进程 | 接收 Master 指令,通过 ProcessBuilder 启动 Executor/Driver JVM |
| 资源追踪 | 实时维护 coresFree 和 memoryFree |
| 进程监控 | 监控子进程退出 → 自动回收资源 |
关键特点:Worker 不参与 Task 调度——Task 由 Driver 直连 Executor RPC 发送。
二、Worker 内部架构全景图
图 1:Spark Worker 内部架构原理
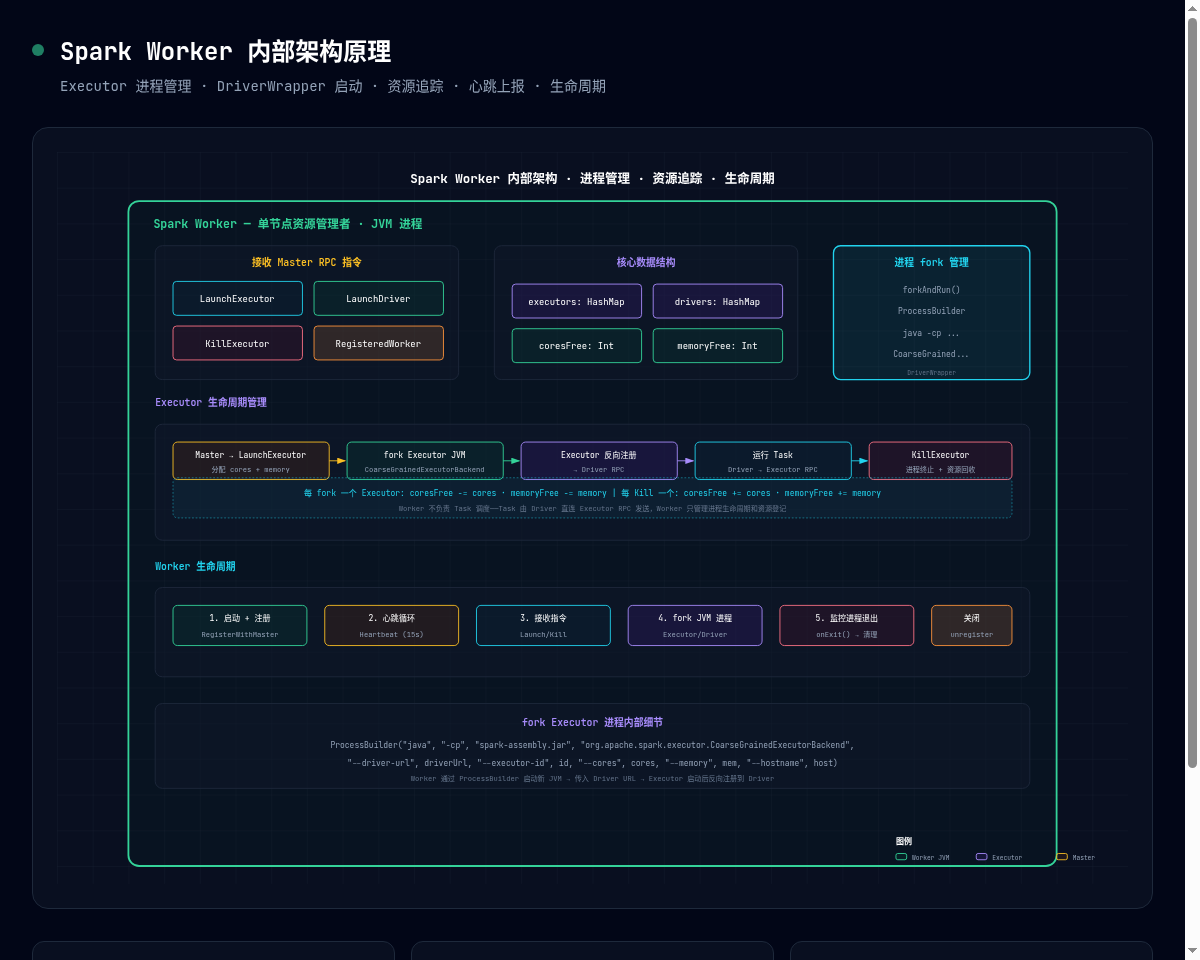
三、核心数据结构
scala
// 源码:Worker.scala
private[worker] class Worker(
    override val rpcEnv: RpcEnv,
    webUiPort: Int,
    cores: Int,          // Worker 分配给 Spark 的总核心数
    memory: Int,          // Worker 分配给 Spark 的总内存
    masterRpcAddresses: Array[RpcAddress],
    ...
) extends ThreadSafeRpcEndpoint {

  // === 核心数据结构 ===
  val executors = new HashMap[String, ExecutorRunner]  // 运行中的 Executor
  val drivers = new HashMap[String, DriverRunner]      // 运行的 Driver (Cluster)

  var coresFree = cores      // 可用核心数
  var memoryFree = memory    // 可用内存

  var master: Option[RpcEndpointRef] = None  // Master RPC 引用
}| 数据结构 | 类型 | 用途 |
|---|---|---|
executors | HashMap | 运行中的 Executor,Key=executorId |
drivers | HashMap | Cluster 模式的 DriverWrapper |
coresFree | Int | 剩余可用核心 |
memoryFree | Int | 剩余可用内存 |
master | RpcEndpointRef | 与 Master 的 RPC 连接 |
四、进程 fork 管理 🔥
这是 Worker 最核心的功能——接收 Master 指令,通过 ProcessBuilder 启动新 JVM。
4.1 LaunchExecutor 处理
scala
// 源码:Worker.scala - 接收 Master 启动 Executor 指令
case LaunchExecutor(masterUrl, appId, execId, appDesc, cores_, memory_) =>
  // 1. 创建 ExecutorRunner
  val manager = new ExecutorRunner(
    appId, execId, appDesc, cores_, memory_,
    self, workerId, host, webUiPort, publicAddress, sparkHome, executorDir, ...)

  // 2. 记录到 executors 映射
  executors(appId + "/" + execId) = manager

  // 3. 启动 Executor 子进程
  manager.start()

  // 4. 扣减本节点可用资源
  coresFree -= cores_
  memoryFree -= memory_

  // 5. 向 Master 汇报最新状态
  masterRef.send(ExecutorStateChanged(appId, execId, manager.state, None, None))
4.2 ExecutorRunner:真正的 ProcessBuilder
scala
// 源码:ExecutorRunner.scala - start()
def start(): Unit = {
  val builder = new ProcessBuilder(
    "java",
    "-cp", "spark-assembly.jar",
    "org.apache.spark.executor.CoarseGrainedExecutorBackend",
    "--driver-url", driverUrl,    // Driver RPC 地址
    "--executor-id", execId,
    "--cores", cores.toString,
    "--memory", memory.toString,
    "--hostname", host
  )

  val process = builder.start()

  // 监控进程退出
  new Thread("ExecutorMonitor") {
    override def run(): Unit = {
      process.waitFor()
      // → 通知 Worker 回收资源
      worker.send(ExecutorStateChanged(appId, execId, ExecutorState.EXITED, ...))
    }
  }.start()
}
4.3 KillExecutor 处理
scala
case KillExecutor(masterUrl, appId, execId) =>
  executors.get(appId + "/" + execId).foreach { executor =>
    executor.kill()          // 终止子进程
    coresFree += executor.cores    // 归还核心
    memoryFree += executor.memory  // 归还内存
    executors -= (appId + "/" + execId)
  }
  masterRef.send(ExecutorStateChanged(appId, execId, ExecutorState.KILLED, ...))
五、Worker 完整生命周期
Phase 1: 启动 → 向 Master 发送 RegisterWorker
   ├── 上报 host/port/cores/memory
   └── Master 返回 RegisteredWorker (含 masterUrl)

Phase 2: 心跳循环 (15s)
   ├── 每次心跳携带 coresFree/memoryFree 等状态
   ├── 同时汇报当前 executors/drivers 列表
   └── Master 据此更新全局资源视图

Phase 3: 接收 Master 指令 (RPC)
   ├── LaunchExecutor → fork Executor JVM
   ├── KillExecutor  → 终止 Executor + 回收资源
   ├── LaunchDriver  → fork DriverWrapper (Cluster)
   └── KillDriver    → 终止 DriverWrapper

Phase 4: 进程退出监控
   ├── ExecutorRunner 监视线程捕获子进程 exit
   ├── 通知 Worker → 通知 Master → 回收资源
   └── Master 重新 schedule() 其他任务

Phase 5: Worker 关闭
   ├── Kill 全部 Executor + Driver
   ├── 向 Master 发送 UnregisterWorker
   └── JVM 退出
六、Worker vs YARN NodeManager 对比
| 维度 | Spark Worker | YARN NodeManager |
|---|---|---|
| 资源抽象 | 直接管理 JVM 进程 | Container (CPU+内存) |
| 资源隔离 | 无(纯 JVM 级别) | Linux Cgroup |
| 多租户 | ❌ | ✅ YARN Queue |
| 进程管理 | ProcessBuilder | ContainerExecutor |
| 适用规模 | 中小集群 | 大规模生产 |
| 复杂度 | 简单 | 复杂(完整容器生命周期) |
七、总结
| 要点 | 总结 |
|---|---|
| 定位 | Worker = 单节点资源管理者,JVM 进程 |
| 核心职责 | fork/kill Executor 和 Driver 进程 |
| 资源追踪 | coresFree + memoryFree 实时维护 |
| 不参与调度 | Task 由 Driver 直连 Executor RPC |
金句:Master 说"启动一个 Executor",Worker 就 fork 一个新 JVM;Master 说"杀了它",Worker 就关闭那个进程。Worker 是 Spark 集群中最忠实的执行者——它不问为什么,只管执行。