
Spark 核心之 Executor 与线程池原理剖析
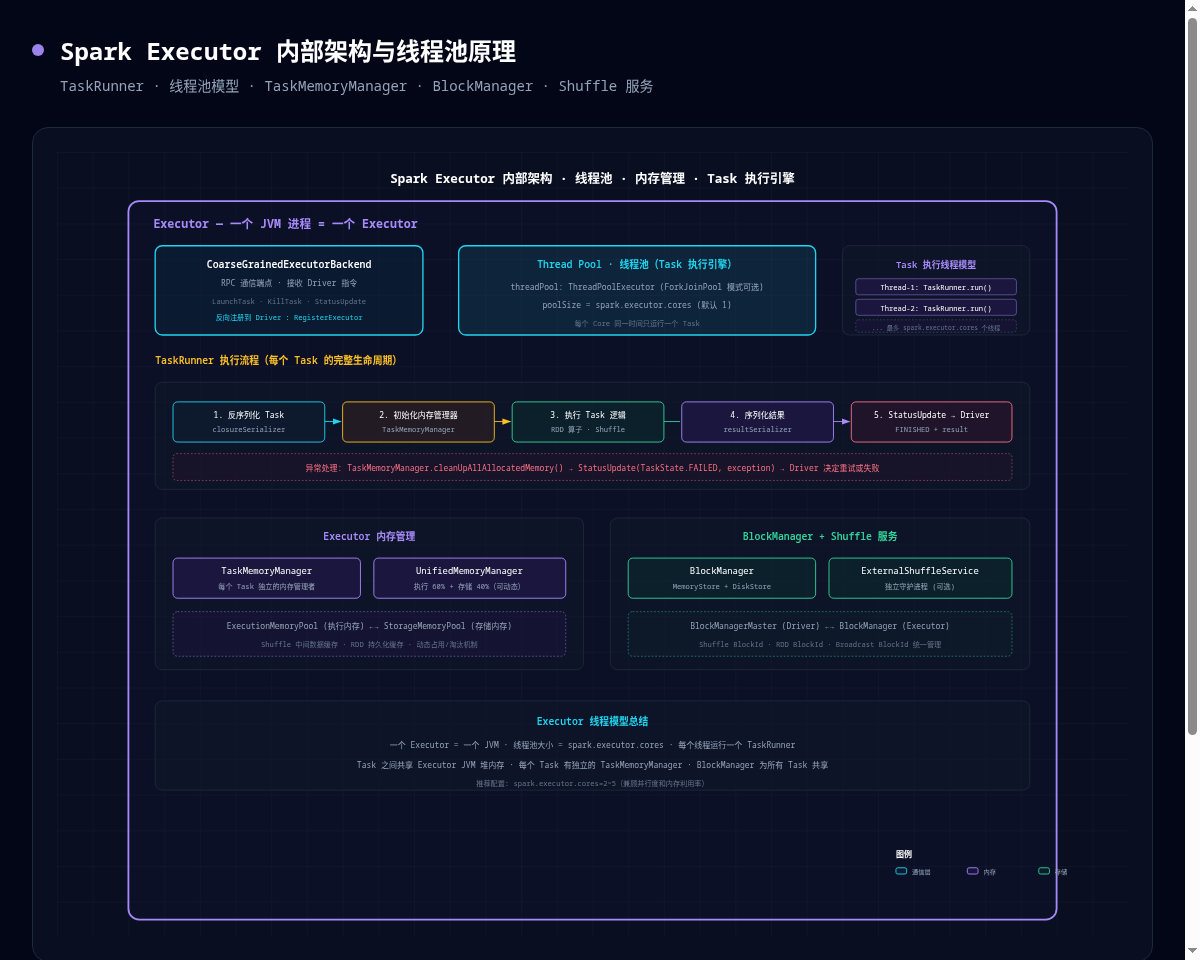
摘要:如果 Driver 是 Spark 的大脑,Executor 就是它的计算引擎。一个 Executor 是一个独立的 JVM 进程,内部通过固定大小的线程池并发执行 Task。本文从 Executor 内部架构全景、CoarseGrainedExecutorBackend 通信层、线程池模型与 TaskRunner 执行引擎、UnifiedMemoryManager 内存管理、BlockManager 存储体系五个维度,配合 1 张原创深色架构图 + 完整源码级分析,带你彻底看清 Executor 的内部世界。
关键词:Spark Executor, TaskRunner, ThreadPoolExecutor, TaskMemoryManager, BlockManager, CoarseGrainedExecutorBackend, Shuffle, 线程池
一、开篇:Executor 是什么?
bash
# 一个 Executor 就是一个 JVM 进程
# spark.executor.cores=4 意味着这个 JVM 内有 4 个线程同时运行 Task
--executor-memory 8G \
--executor-cores 4
Executor 是 Spark 的计算执行单元,它承载了以下核心职责:
| 职责 | 说明 |
|---|---|
| 接收 Task | 从 Driver 接收序列化的 Task 对象 |
| 反序列化 + 执行 | 反序列化闭包 → 执行 RDD 算子逻辑 |
| 内存管理 | TaskMemoryManager + UnifiedMemoryManager |
| 数据存储 | BlockManager (MemoryStore + DiskStore) |
| Shuffle 服务 | 写 Shuffle 数据、服务远程读取 |
| 结果回传 | 序列化结果 → StatusUpdate → Driver |
二、Executor 内部架构全景图
图 1:Spark Executor 内部架构与线程池原理
三、CoarseGrainedExecutorBackend:通信层
scala
// 源码:CoarseGrainedExecutorBackend.scala
class CoarseGrainedExecutorBackend(
    driverUrl: String, executorId: String, hostname: String,
    cores: Int, ...)
  extends ThreadSafeRpcEndpoint {

  override def onStart(): Unit = {
    // 🔑 反向注册到 Driver
    rpcEnv.asyncSetupEndpointRefByURI(driverUrl).flatMap { ref =>
      driver = Some(ref)
      ref.ask[Boolean](RegisterExecutor(executorId, self, hostname, cores, ...))
    }
  }

  // 接收 Driver 指令
  override def receive: PartialFunction[Any, Unit] = {
    case LaunchTask(data) => executor.launchTask(this, data)  // 启动 Task
    case KillTask(taskId, ...) => executor.killTask(taskId, ...)
    case StopExecutor => ...
  }
}
四、线程池模型 🔥
4.1 Executor 的线程池初始化
scala
// 源码:Executor.scala
private[executor] class Executor(
    executorId: String, executorHostname: String,
    env: SparkEnv, ...) extends Logging {

  // 固定大小线程池 — 大小 = spark.executor.cores
  private val threadPool = {
    val threadFactory = new ThreadFactoryBuilder()
      .setDaemon(true)
      .setNameFormat("Executor task launch worker-%d")
      .build()
    Executors.newFixedThreadPool(executorCores, threadFactory)
  }
  // 等价于 new ThreadPoolExecutor(corePoolSize, corePoolSize, ...)
}关键特征:固定大小线程池,corePoolSize = maxPoolSize = spark.executor.cores。
4.2 TaskRunner:Task 执行体
scala
// 源码:Executor.scala - TaskRunner
class TaskRunner(execBackend: ExecutorBackend, taskDescription: TaskDescription)
  extends Runnable {

  override def run(): Unit = {
    // === Step 1: 反序列化 Task ===
    val ser = SparkEnv.get.closureSerializer.newInstance()
    val task = ser.deserialize[Task[Any]](taskDescription.serializedTask)

    // === Step 2: 设置 TaskMemoryManager ===
    val taskMemoryManager = new TaskMemoryManager(env.memoryManager, taskId)

    // === Step 3: 执行 Task ===
    val res = task.run(taskAttemptId, taskMemoryManager, ...)

    // === Step 4: 序列化结果 ===
    val resultSer = SparkEnv.get.serializer.newInstance()
    val serializedResult = resultSer.serialize(new DirectTaskResult(res))

    // === Step 5: 回传 Driver ===
    execBackend.statusUpdate(taskId, TaskState.FINISHED, serializedResult)
  }
}
4.3 Task 提交到线程池
scala
def launchTask(context: ExecutorBackend, taskDescription: TaskDescription): Unit = {
  val tr = new TaskRunner(context, taskDescription)
  runningTasks.put(taskDescription.taskId, tr)
  threadPool.execute(tr)  // 提交到固定大小线程池
}
五、内存管理
5.1 UnifiedMemoryManager
┌─────────────────────────────────────────┐
│         UnifiedMemoryManager            │
│  ┌───────────────┐  ┌────────────────┐  │
│  │ExecutionMemory │  │ StorageMemory  │  │
│  │   (执行 60%)    │  │  (存储 40%)    │  │
│  │ Shuffle 缓冲区  │  │ RDD 缓存       │  │
│  └───────────────┘  └────────────────┘  │
│         ↕ 动态占用/淘汰 (spill to disk)   │
└─────────────────────────────────────────┘
scala
// TaskMemoryManager 为每个 Task 提供独立的内存管理
val taskMemoryManager = new TaskMemoryManager(env.memoryManager, taskId)
// 从 ExecutionMemoryPool 申请内存
val page = taskMemoryManager.allocatePage(size, consumer)
六、BlockManager 存储体系
| 组件 | 职责 |
|---|---|
| BlockManager | Executor 级存储管理(Memory + Disk) |
| MemoryStore | 内存存储(LinkedHashMap,LRU 淘汰) |
| DiskStore | 磁盘存储(Shuffle 文件、RDD 缓存溢出) |
| BlockManagerMaster | 在 Driver 端管理全局 Block 元数据 |
| ExternalShuffleService | 独立守护进程,Executor 退出后仍可服务 Shuffle 读取 |
七、Executor 配置调优
bash
spark-submit \
  --executor-memory 8G \             # Executor JVM 堆内存
  --executor-cores 4 \               # 线程池大小 = 4
  --conf spark.executor.memoryOverhead=1G \  # 堆外内存
  --conf spark.memory.fraction=0.6 \         # 执行+存储占比
  --conf spark.memory.storageFraction=0.5 \  # 存储占 memoryFraction 的比例
  --conf spark.shuffle.service.enabled=true \ # 外部 Shuffle 服务
  my-app.jar
八、总结
| 要点 | 总结 |
|---|---|
| Executor 本质 | 一个运行 CoarseGrainedExecutorBackend 的 JVM 进程 |
| 线程池 | 固定大小 ThreadPoolExecutor,大小 = spark.executor.cores |
| TaskRunner | 反序列化 → 内存初始化 → 执行 → 序列化结果 → StatusUpdate |
| 内存 | UnifiedMemoryManager 统一管理执行+存储内存 |
| 存储 | BlockManager: MemoryStore + DiskStore + Shuffle 服务 |
金句:如果说 Driver 是 Spark 的 CEO(制定策略、分配任务),Executor 就是 Spark 的工程师——它不关心 DAG 如何切分,只专注于把手头的每一个 Task 高效执行到底。