
Spark 核心之 Client 模式提交命令和特点分析
摘要:spark-submit 是用 Spark 的第一道门槛。一条命令背后隐藏着 Driver 位置、资源分配策略、参数优先级、Standalone vs YARN 差异等大量关键决策。本文从 spark-submit 命令结构全景、Standalone-Client 与 YARN-Client 命令对比、六大核心参数详解、四种 Client 模式场景模板、参数优先级机制五个维度,配合 1 张原创深色架构图和完整可运行示例,让你彻底掌握 Spark Client 模式的提交命令。
关键词:spark-submit, Client 模式, Standalone-Client, YARN-Client, --master, --deploy-mode, 参数体系, Driver 配置
一、开篇:你会写 spark-submit 吗?
先看一道面试题:
下面两条命令分别启动了哪种部署模式?Driver 运行在哪里?区别是什么?
# 命令 A
spark-submit --master spark://master:7077 --deploy-mode client app.jar

# 命令 B
spark-submit --master yarn --deploy-mode client app.jar
如果你能准确回答——说明你对 Spark 部署模式的参数体系已经有了系统理解。如果你犹豫了——这篇文章将帮你彻底理清 Client 模式的所有提交命令和参数。
二、spark-submit 命令全景图
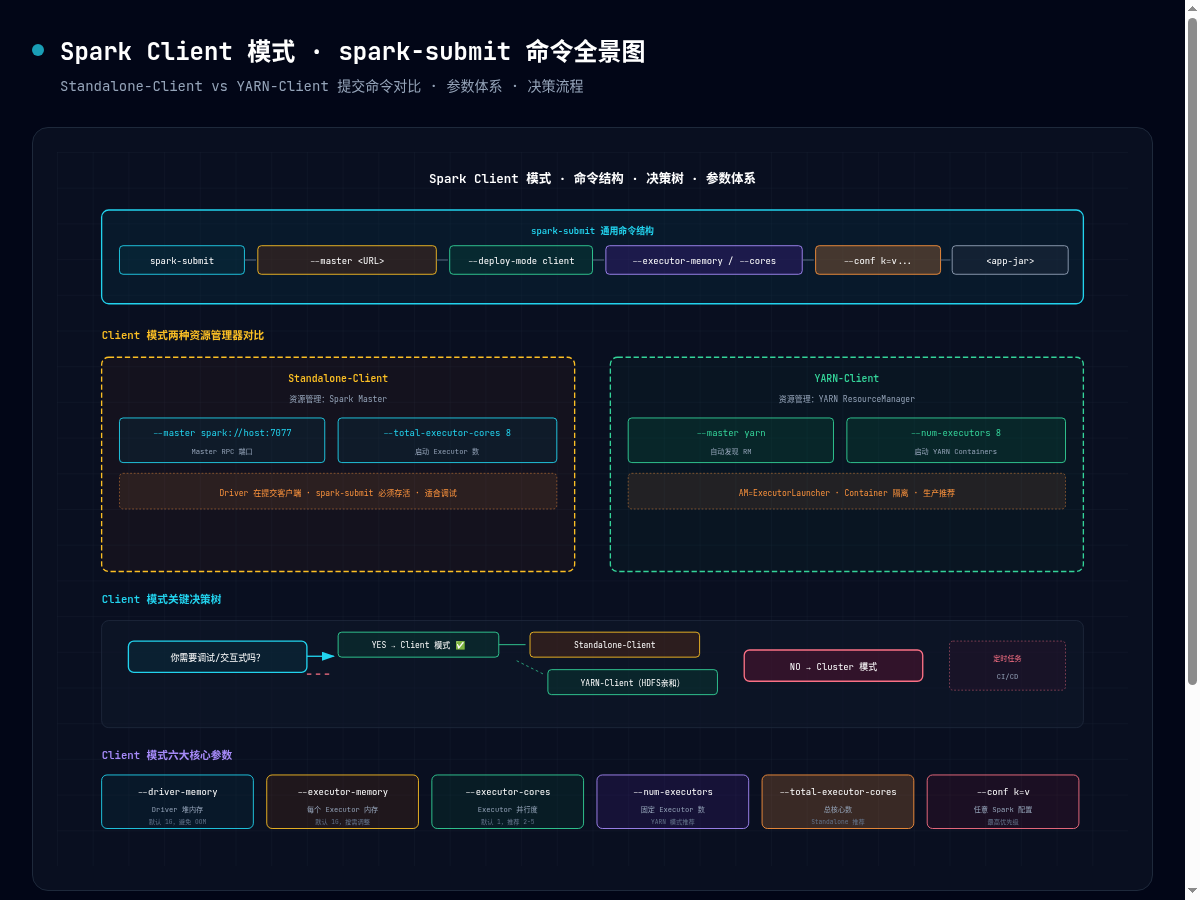
图 1:Spark Client 模式 spark-submit 命令全景图
2.1 通用命令结构
spark-submit [通用选项] [应用选项] [配置选项] <app-jar | python-file | R-file> [app-args]每个选项组的作用:
| 选项组 | 前缀 | 核心参数 | 示例 |
|---|---|---|---|
| 通用选项 | --master --deploy-mode | 集群地址、部署模式 | --master yarn |
| 应用选项 | --class --name --jars | 主类、应用名、依赖 | --class com.example.Main |
| Driver 配置 | --driver-* | Driver 内存、核心数 | --driver-memory 2G |
| Executor 配置 | --executor-* --num-executors | Executor 资源 | --executor-memory 4G |
| 动态配置 | --conf k=v | 任意 Spark 配置 | --conf spark.sql.shuffle.partitions=200 |
2.2 --master 决定了资源管理器
# Standalone
--master spark://master:7077

# YARN
--master yarn

# YARN HA(多个 RM)
--master yarn --conf spark.yarn.ha.enabled=true

# 本地测试
--master local[4]
2.3 --deploy-mode client 决定 Driver 位置
Client 模式的核心语义:Driver 在提交客户端 JVM 中运行。
# 显式指定(推荐)
--deploy-mode client

# 省略时的默认值(取决于 --master)
# --master spark://...     → 默认 client
# --master yarn             → 默认 client
# --master local[...]       → 始终 client
三、Standalone-Client 提交命令
3.1 完整模板
spark-submit \
  --master spark://master-node:7077 \
  --deploy-mode client \
  --class com.example.SparkApp \
  --name "my-standalone-client-app" \
  --driver-memory 2G \
  --driver-cores 2 \
  --executor-memory 4G \
  --executor-cores 2 \
  --total-executor-cores 8 \
  --conf spark.driver.port=4040 \
  --conf spark.driver.host=192.168.1.100 \
  --conf spark.default.parallelism=16 \
  --conf spark.serializer=org.apache.spark.serializer.KryoSerializer \
  /path/to/my-app.jar \
  arg1 arg2
3.2 Standalone-Client 特有参数
| 参数 | 说明 | 默认值 |
|---|---|---|
--total-executor-cores | 总核心数(Standalone 特有) | 所有 Worker 可用核心 |
--executor-cores | 每个 Executor 核心数 | 1 |
--driver-cores | Driver 核心数(本地 JVM) | 1 |
注意:Standalone 没有 --num-executors——Executor 数量由 --total-executor-cores / --executor-cores 自动计算。
3.3 spark-shell(交互式 Client)
# spark-shell 默认就是 Standalone-Client 模式
spark-shell \
  --master spark://master:7077 \
  --executor-memory 4G \
  --total-executor-cores 8
# 等价于 --deploy-mode client(默认值)
四、YARN-Client 提交命令
4.1 完整模板
spark-submit \
  --master yarn \
  --deploy-mode client \
  --class com.example.SparkApp \
  --name "my-yarn-client-app" \
  --driver-memory 2G \
  --executor-memory 4G \
  --executor-cores 2 \
  --num-executors 8 \
  --conf spark.yarn.am.memory=1G \
  --conf spark.yarn.am.cores=1 \
  --conf spark.yarn.queue=default \
  --conf spark.yarn.maxAppAttempts=2 \
  --conf spark.eventLog.enabled=true \
  --conf spark.eventLog.dir=hdfs:///spark-logs \
  /path/to/my-app.jar
4.2 YARN-Client 特有参数
| 参数 | 说明 | 默认值 |
|---|---|---|
--num-executors | 固定 Executor 数量 | 2 |
spark.yarn.am.memory | AM(ExecutorLauncher) 内存 | 1G |
spark.yarn.am.cores | AM 核心数 | 1 |
spark.yarn.queue | YARN 队列 | default |
spark.yarn.maxAppAttempts | AM 最大重试次数 | 2 |
4.3 spark-shell on YARN
spark-shell \
  --master yarn \
  --deploy-mode client \
  --executor-memory 4G \
  --num-executors 8
五、Standalone-Client vs YARN-Client 命令差异速记
# ======== Standalone-Client ========
spark-submit \
  --master spark://master:7077 \
  --deploy-mode client \
  --total-executor-cores 8 \          # ← 总核心数控制并行度
  --executor-memory 4G \
  app.jar

# ======== YARN-Client ========
spark-submit \
  --master yarn \
  --deploy-mode client \
  --num-executors 8 \                 # ← 固定 Executor 数量
  --executor-memory 4G \
  --conf spark.yarn.queue=default \   # ← YARN 专属
app.jar| 维度 | Standalone-Client | YARN-Client |
|---|---|---|
| 资源指定 | --total-executor-cores | --num-executors |
| Master 地址 | spark://host:7077 | yarn |
| 队列管理 | 无 | spark.yarn.queue |
| AM 配置 | 无 | spark.yarn.am.* |
| 日志聚合 | 无 | HDFS 事件日志 |
六、参数优先级机制
Spark 参数有三层来源,优先级从高到低:
优先级:--conf k=v  >  --<parameter>  >  spark-defaults.conf  >  代码中的 set()
       (命令行最高)  (专用选项)      (配置文件)           (代码最低)
相同参数冲突时,后指定的覆盖前指定的:
# --executor-memory 最终为 8G(后指定的生效)
spark-submit \
  --executor-memory 4G \
  --executor-memory 8G \
  app.jar
七、四种 Client 模式实战场景
场景 1:本地开发调试
spark-submit \
  --master local[4] \
  --driver-memory 2G \
  my-app.jar
场景 2:Standalone 集群交互分析
spark-shell \
  --master spark://master:7077 \
  --executor-memory 8G \
  --total-executor-cores 16
场景 3:YARN 集群生产级提交
spark-submit \
  --master yarn \
  --deploy-mode client \
  --driver-memory 4G \
  --executor-memory 8G \
  --executor-cores 4 \
  --num-executors 20 \
  --conf spark.yarn.queue=production \
  --conf spark.sql.shuffle.partitions=400 \
  etl-job.jar 2025-01-01
场景 4:Python PySpark on YARN
spark-submit \
  --master yarn \
  --deploy-mode client \
  --executor-memory 4G \
  --num-executors 8 \
  --conf spark.pyspark.python=/usr/bin/python3 \
  my-ml-pipeline.py --input hdfs:///data/raw
八、总结
| 要点 | 一句话总结 |
|---|---|
| 命令结构 | spark-submit [通用] [应用] [配置] <jar> |
| --master | 决定资源管理器:spark:// vs yarn vs local |
| --deploy-mode | Client = Driver 在提交客户端 |
| 资源参数 | Standalone 用 --total-executor-cores,YARN 用 --num-executors |
| 优先级 | --conf > --param > spark-defaults.conf > 代码 |
金句:掌握 spark-submit 命令不是目的——通过命令理解 Driver 在哪、资源如何分配、参数如何覆盖,才是工程师的竞争力所在。