
SparkSQL 之 Spark On Hive 原理分析及配置
摘要:Spark on Hive 与 Hive on Spark 常被混淆——前者 Spark 是主角访问 Hive 元数据,后者 Hive 用 Spark 作执行引擎。本文从 enableHiveSupport() 启动流程、HiveExternalCatalog、Metastore 集成、SerDe/UDF、Thrift Server 多用户方案、以及两者对比六个维度全面解析。
关键词:Spark on Hive, enableHiveSupport, Hive Metastore, HiveExternalCatalog, Thrift Server
一、开篇:Spark on Hive ≠ Hive on Spark!
Spark on Hive: Spark 是主角 → enableHiveSupport()
  访问 Metastore 获取表结构 → Spark 引擎读写 Hive 表

Hive on Spark: Hive 是主角 → set engine=spark
  HiveServer2 接收 HQL → RSC → Spark Executor
二、架构全景
图 1:SparkSession→Hive Metastore→HDFS→Thrift Server
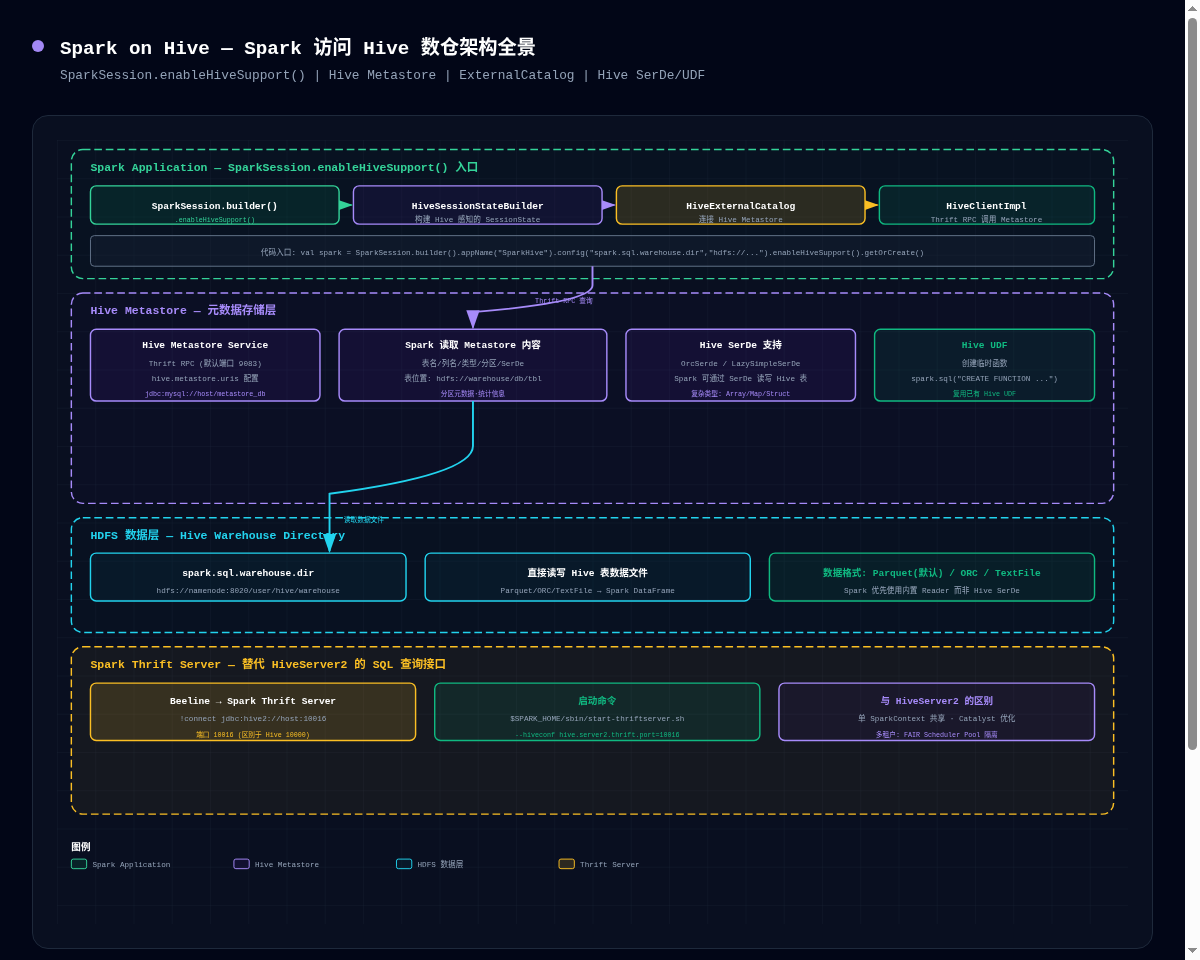
enableHiveSupport() 做了什么
scala
val spark = SparkSession.builder()
  .config("spark.sql.warehouse.dir", "hdfs://...")
  .enableHiveSupport()    // ← 核心入口
  .getOrCreate()

// ① 加载 hive-site.xml
// ② 创建 HiveSessionStateBuilder
// ③ 实例化 HiveExternalCatalog → 连接 Metastore
// ④ 加载 Hive UDF · Hive SerDe
// ⑤ spark.sql("show tables") 直接查询 Hive 表
Metastore 集成
scala
spark.sql("SELECT * FROM hive_db.hive_table")  // 直接查 Hive 表
spark.table("hive_db.hive_table")               // DataFrame API
// 与 Hive 共享同一套元数据,数据写入 HDFS Warehouse
三、核心对比
图 2:概念对比 + Thrift Server 配置
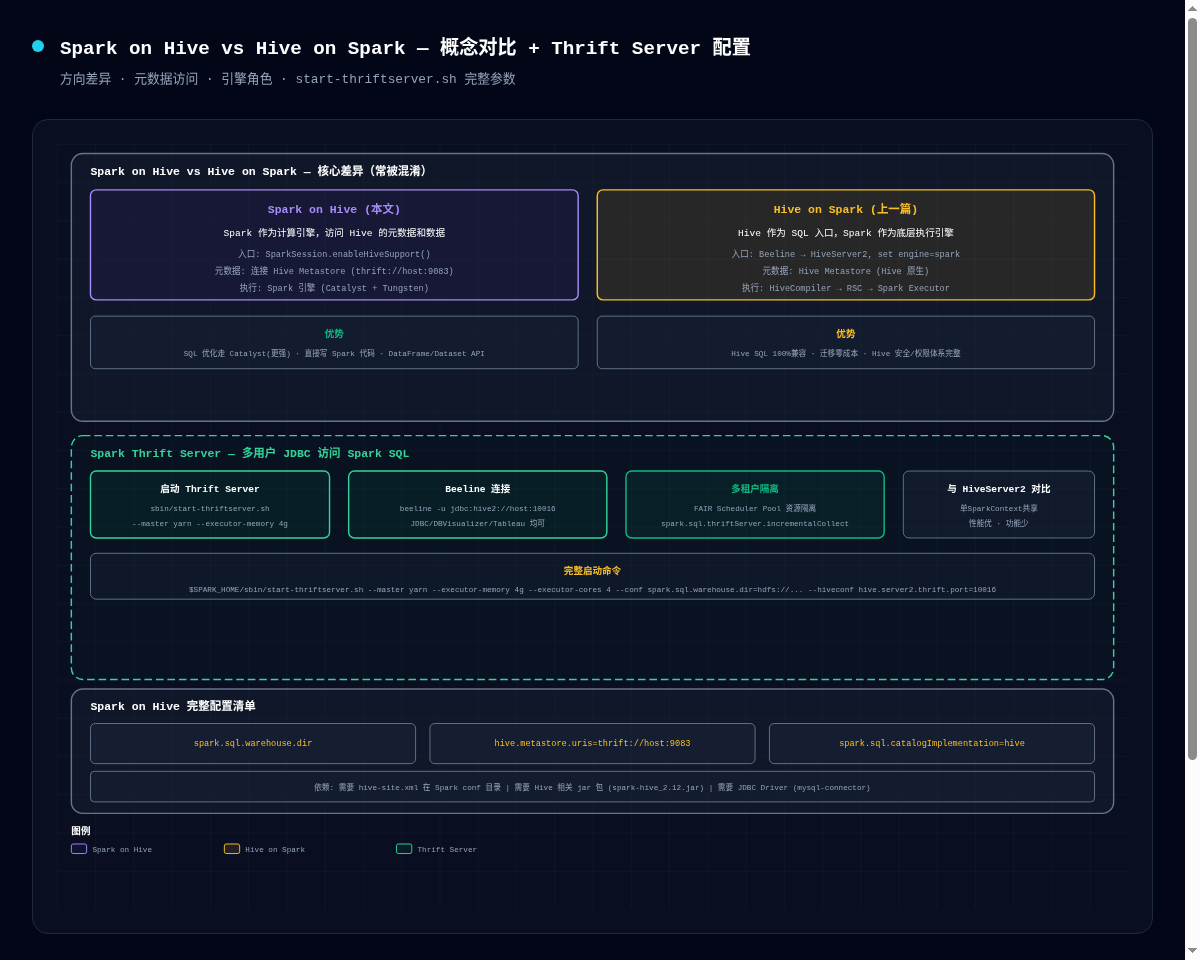
| Spark on Hive | Hive on Spark | |
|---|---|---|
| 主角 | Spark | Hive |
| 入口 | enableHiveSupport() | set engine=spark |
| SQL接口 | spark.sql() | Beeline→HiveServer2 |
| 优化器 | Catalyst(更强) | Hive Optimizer |
| JDBC服务 | Thrift Server(10016) | HiveServer2(10000) |
四、Thrift Server
bash
$SPARK_HOME/sbin/start-thriftserver.sh \
  --master yarn --executor-memory 4g
# Beeline: jdbc:hive2://host:10016
五、完整配置
xml
<!-- hive-site.xml -->
hive.metastore.uris=thrift://host:9083
scala
// spark-defaults.conf
spark.sql.warehouse.dir=hdfs://...
spark.sql.catalogImplementation=hive
spark.sql.hive.convertMetastoreParquet=true作者:starzy
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践