
Spark 核心之 Master 原理剖析
摘要:Spark Master 是 Standalone 模式的"集群大脑"。它管理所有 Worker 的注册与心跳,调度 Driver 和 Application 的资源分配,通过 SpreadOutApps 算法确保负载均衡,借助 ZooKeeper 实现主备选举和状态恢复。本文从 Master 内部架构全景、核心数据结构、schedule() 调度引擎源码、Worker 生命周期管理、HA 高可用机制五个维度,配合 1 张原创深色架构图 + 完整源码分析,带你彻底看清 Master 的内部世界。
关键词:Spark Master, schedule(), Worker 管理, 资源调度, SpreadOutApps, HA, ZooKeeper, LeaderElection, PersistenceEngine
一、开篇:Master 是什么?
如果说 Driver 是单个应用的"大脑",那么 Master 就是整个 Standalone 集群的"指挥中心"。
| 职责 | 说明 |
|---|---|
| Worker 管理 | 注册、心跳、超时检测、资源登记 |
| 资源调度 | Driver 调度 + Application Executor 资源分配 |
| 应用生命周期 | 注册 → 排队 → 调度 → 完成 → 移除 |
| HA 高可用 | ZK 主备选举、状态持久化、故障自动切换 |
一句话定位:Master 不执行 Task,不做 DAG 解析——它只做一件事:谁需要资源、谁有资源、把资源分给谁。
二、Master 内部架构全景图
图 1:Spark Master 内部架构原理
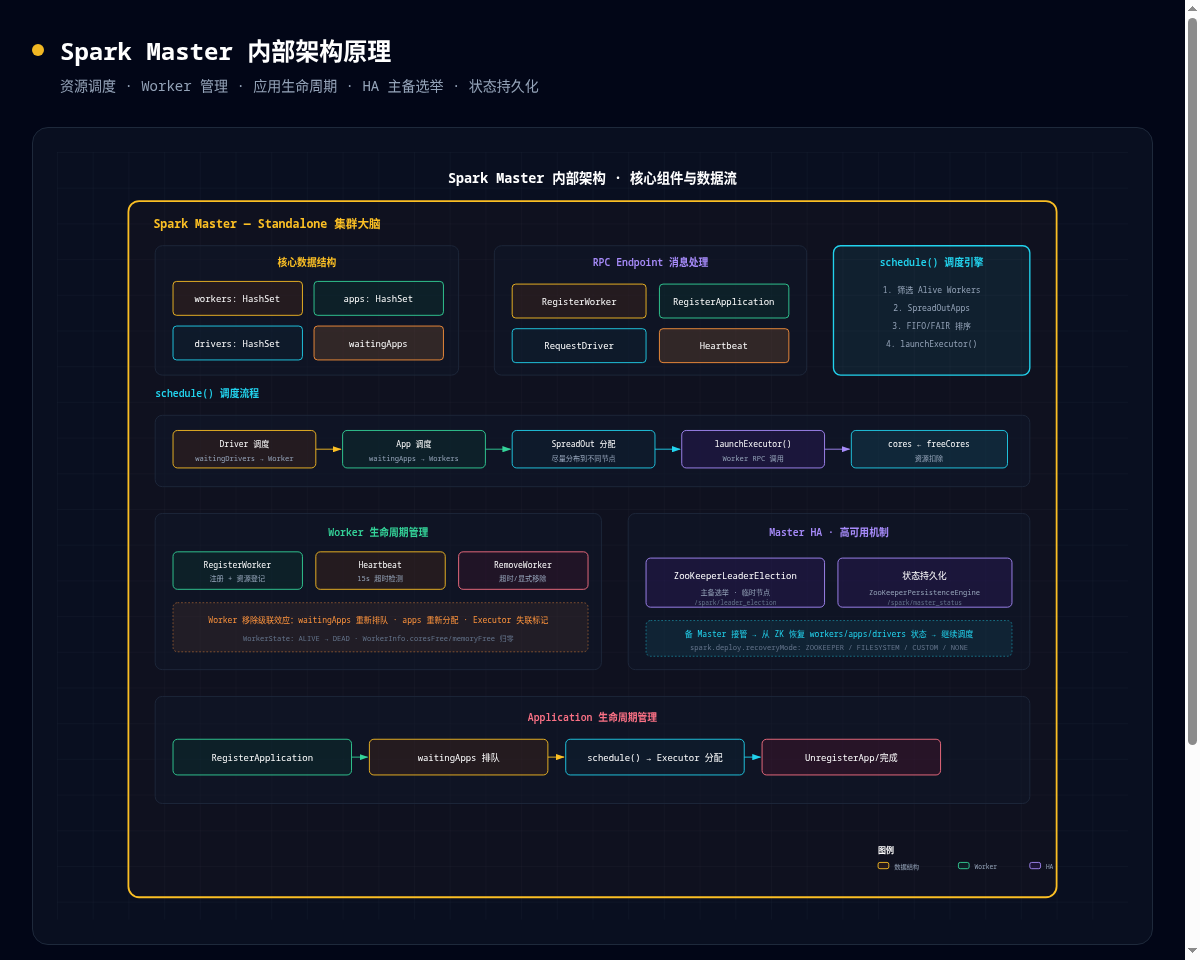
Master 四大核心模块
┌────────────────────────────────────────────┐
│                 Spark Master               │
│  ┌──────────────┐  ┌──────────────────┐    │
│  │ 核心数据结构   │  │  schedule() 引擎  │    │
│  │ workers: Set  │  │ SpreadOutApps    │    │
│  │ apps: Set     │  │ FIFO/FAIR 策略   │    │
│  │ drivers: Set  │  │ launchExecutor() │    │
│  └──────────────┘  └──────────────────┘    │
│  ┌──────────────┐  ┌──────────────────┐    │
│  │ RPC Endpoint  │  │   HA 高可用       │    │
│  │ RegisterWorker│  │ LeaderElection   │    │
│  │ RegisterApp   │  │ PersistenceEngine│    │
│  │ Heartbeat     │  │ 状态恢复          │    │
│  └──────────────┘  └──────────────────┘    │
└────────────────────────────────────────────┘
三、核心数据结构
// 源码:Master.scala
private[master] class Master(
    override val rpcEnv: RpcEnv,
    address: RpcAddress,
    webUiPort: Int,
    val securityMgr: SecurityManager,
    val conf: SparkConf)
  extends ThreadSafeRpcEndpoint {

  // === 核心数据结构 ===
  val workers = new HashSet[WorkerInfo]          // 已注册的 Worker
  val apps = new HashSet[ApplicationInfo]        // 运行中的应用
  val drivers = new HashSet[DriverInfo]          // 已提交的 Driver (Cluster 模式)

  // === 等待队列 ===
  val waitingApps = new ArrayBuffer[ApplicationInfo]   // 等待资源分配的应用
  val waitingDrivers = new ArrayBuffer[DriverInfo]     // 等待 Worker 的 Driver

  // === 已完成的应用(数量限制,用于 Web UI 展示)===
  private val completedApps = new ArrayBuffer[ApplicationInfo]
  private val completedDrivers = new ArrayBuffer[DriverInfo]
}| 数据结构 | 类型 | 用途 |
|---|---|---|
workers | HashSet | 所有已注册的 Worker |
apps | HashSet | 运行中的 Application |
drivers | HashSet | Cluster 模式提交的 Driver |
waitingApps | ArrayBuffer | 排队等待资源分配的应用 |
waitingDrivers | ArrayBuffer | 排队等待 Worker 的 Driver |
四、schedule() 调度引擎 🔥
这是 Master 最核心的方法——每次状态变更都会触发调用。
// 源码:Master.scala - schedule() 核心逻辑
private def schedule(): Unit = {
  // Step 1: 先调度 Driver (Cluster 模式)
  for (driver <- waitingDrivers.toList) {
    val worker = workers.filter(_.state == WorkerState.ALIVE)
      .filter(canLaunchDriver(_, driver.desc)).headOption
    worker.foreach { w =>
      waitingDrivers -= driver
      w.endpoint.send(LaunchDriver(driver.id, driver.desc))
      driver.state = DriverState.RUNNING
    }
  }

  // Step 2: 再调度 Application (Executor 分配)
  startExecutorsOnWorkers()
}
4.1 SpreadOutApps 负载均衡算法
// 源码:startExecutorsOnWorkers()
private def startExecutorsOnWorkers(): Unit = {
  for (app <- waitingApps if app.coresLeft > 0) {
    val usableWorkers = workers.filter(_.state == WorkerState.ALIVE)
      .filter(canLaunchExecutor(_, app.desc))

    // SpreadOut: 尽可能将 Executor 分散到不同 Worker
    // 每个 Worker 分配尽可能少的 cores(最少 1 个 Executor)
    val numWorkers = usableWorkers.length
    var coresPerWorker = app.desc.maxCores.getOrElse(Int.MaxValue) / numWorkers
    if (coresPerWorker < 1) coresPerWorker = 1

    for (worker <- usableWorkers if app.coresLeft > 0) {
      val coresToUse = math.min(worker.coresFree, coresPerWorker)
      launchExecutor(worker, app, coresToUse)
    }
  }
}
SpreadOut 策略的优势:将任务分散到更多节点 → 更高的数据本地性命中率 → 减少 Shuffle 网络开销。
五、Worker 生命周期管理
Worker 启动 → RegisterWorker → Master 登记 → Heartbeat (每 15s)
                                         ↓
                                    超时未心跳?
                                   /         \
                                 NO           YES
                              继续运行     RemoveWorker
                                            ↓
                                        状态标记 DEAD
                                        waitingApps 重新排队
apps 中的 Executor 失联// Worker 心跳超时检测
case Heartbeat(workerId, worker) =>
worker.lastHeartbeat = System.currentTimeMillis()
// 15 秒超时检查在 checkForWorkerTimeOuts() 中级联效应:Worker 宕机 → RemoveWorker → 释放的资源重新进入 schedule() → 其他 Worker 承接任务。
六、Master HA:ZooKeeper 主备选举
# 启动 HA Master 集群
# Master 1
./sbin/start-master.sh -h master-1 --webui-port 8080 \
  --conf spark.deploy.recoveryMode=ZOOKEEPER \
  --conf spark.deploy.zookeeper.url=zk1:2181,zk2:2181,zk3:2181

# Master 2 (备)
./sbin/start-master.sh -h master-2 --webui-port 8080 \
  --conf spark.deploy.recoveryMode=ZOOKEEPER \
  --conf spark.deploy.zookeeper.url=zk1:2181,zk2:2181,zk3:2181
6.1 选举机制
// 源码:ZooKeeperLeaderElectionAgent.scala
class ZooKeeperLeaderElectionAgent(val masterInstance: LeaderElectable,
    conf: SparkConf, securityMgr: SecurityManager, zkUrl: String)
  extends LeaderElectionAgent {

  // 在 ZK 创建临时顺序节点 /spark/leader_election/lock-0000000xxx
  // 序号最小的节点成为 Leader
  // Leader 宕机 → 临时节点自动删除 → 下一个最小序号成为新 Leader
}
6.2 状态持久化与恢复
// 恢复模式
sealed trait RecoveryMode
case object ZOOKEEPER extends RecoveryMode
case object FILESYSTEM extends RecoveryMode  // 本地文件系统
case object CUSTOM extends RecoveryMode      // 自定义实现
case object NONE extends RecoveryMode // 无 HA恢复流程:新 Leader 从持久化存储读取 → 恢复 workers/apps/drivers 状态 → 执行 schedule() 继续调度。
七、总结
| 要点 | 总结 |
|---|---|
| 定位 | Master = 集群资源调度中心,不执行 Task/DAG |
| 核心方法 | schedule():Driver + Executor 资源分配 |
| 调度策略 | SpreadOutApps 分散负载 + FIFO/FAIR 排队 |
| 数据结构 | workers/apps/drivers/waitingApps/waitingDrivers |
| HA | ZK 临时节点选举 + 持久化状态恢复 |
金句:如果 Driver 是单个应用的大脑,Master 就是整个集群的交管中心——它不跑车,但它决定哪辆车走哪条路。