
Spark 核心之 MasterHA 高可用原理及配置详解
摘要:Spark Standalone 集群的 Master 节点是资源调度的核心,一旦宕机整个集群陷入瘫痪。Master HA 通过 ZooKeeper 实现 Active-Standby 多 Master 架构,支持自动故障切换和状态恢复。本文从 ZooKeeperLeaderElectionAgent 选主原理、Active/Standby 角色行为、三种恢复模式(ZooKeeper/FILESYSTEM/NONE)对比、完整配置与启动流程四个维度,配合 2 张架构图,彻底解析 Spark Master HA 的高可用机制。
关键词:Spark Master HA, ZooKeeper, Leader Election, Active-Standby, 恢复模式, PersistenceEngine, Failover
一、开篇:Master 单点故障的致命性
在 Spark Standalone 集群中,Master 是绝对的调度中心——它负责接收 Worker 注册、管理资源、调度 Driver 和 Application。一旦唯一的 Master 宕机:
Master 宕机后的连锁反应
├── 所有 Worker 失去心跳目标 → 自动退出
├── Running Applications → 继续运行但不可调度新任务
├── 新 Driver/Application 提交 → 全部失败
├── 集群状态信息 → 不可查询且不可恢复(默认 NONE 模式)
└── 唯一恢复方式 → 重启 Master + 全部 Worker 重新注册
Master HA(High Availability) 正是为解决这一单点问题而生。核心思路:多个 Master 节点 + ZooKeeper 协调选举,任一宕机自动切换。
二、Master HA 架构全景
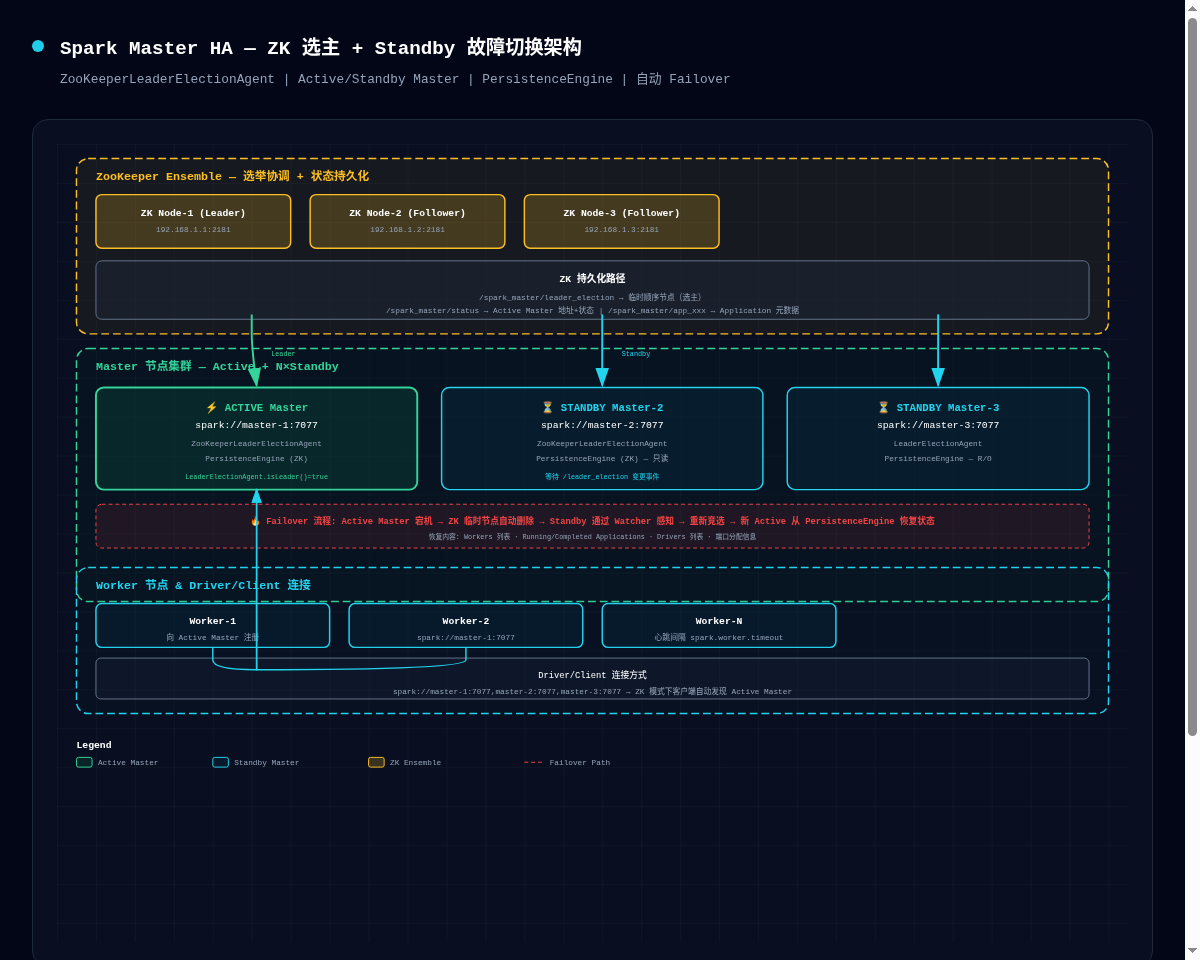
图 1:Spark Master HA — ZK 选主 + Active-Standby 故障切换全景架构
2.1 角色分工
Active Master (Leader)
├── 接收 Worker 注册与心跳
├── 调度 Driver/Application
├── 资源分配、端口管理
├── 写 PersistenceEngine (ZK)
└── 定期更新 ZK /leader_election 临时节点

Standby Master (Follower)
├── 监听 ZK /leader_election 变化
├── PersistenceEngine 只读
├── 不处理 Worker 心跳
└── 随时准备接管(< 30s)
2.2 ZK 选主流程
① 每个 Master 启动 → 连接 ZK 集群
② 在 /spark_master/leader_election 下创建临时顺序节点
③ 序号最小的节点 → 成为 Active Master(Leader)
④ 其他 Master → Standby,设置 Watcher 监听前序节点
⑤ Active Master 宕机 → 临时节点自动删除 → ZK 通知
⑥ 序号次小的 Standby 感知 → 立即竞选 → 成为新 Active
三、恢复模式深度对比
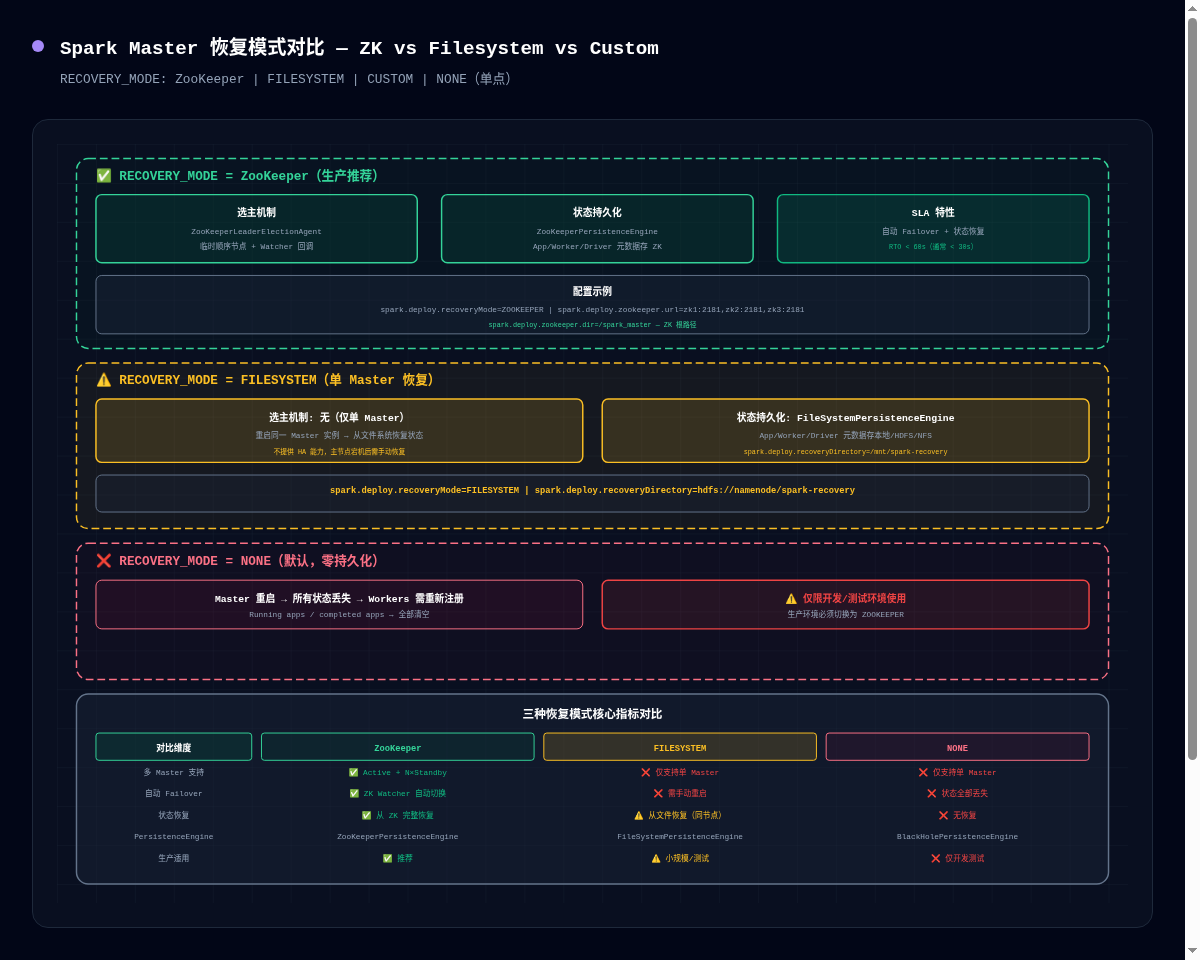
图 2:Spark Master 三种恢复模式对比 — ZK vs FILESYSTEM vs NONE
3.1 重量级对比
                     ZooKeeper            FILESYSTEM         NONE
──────────────────────────────────────────────────────────────────
多 Master             ✅ Active+N Standby  ❌ 仅单Master      ❌
自动 Failover         ✅ (<30s)            ❌ 需手动重启      ❌
状态恢复             ✅ 完整恢复           ⚠️ 同节点恢复     ❌ 全部丢失
PersistenceEngine    ZooKeeperPE          FileSystemPE       BlackHolePE
LeaderElectionAgent  ZKLeaderElection     MonarchyLeader     MonarchyLeader
生产推荐             ✅ 强烈推荐           ⚠️ 小规模过渡     ❌ 仅开发
3.2 FILESYSTEM 的局限性
FILESYSTEM 模式不是真正的高可用——它仅支持 Master 重启后从文件系统恢复状态,无法实现多 Master 自动切换。适用场景:单 Master 测试环境或需保留完成状态但不需要连续服务的过渡方案。
3.3 CUSTOM 自定义模式
RECOVERY_MODE=CUSTOM
实现 StandaloneRecoveryModeFactory 接口
→ 自定义 LeaderElectionAgent
→ 自定义 PersistenceEngine
→ 可接入 etcd / Consul / 自研选举系统
四、完整配置与启动
4.1 spark-env.sh 配置
# 每个 Master 节点的 spark-env.sh
export SPARK_MASTER_HOST=master-1          # 当前节点 IP
export SPARK_MASTER_PORT=7077
export SPARK_MASTER_WEBUI_PORT=8080

# ZK HA 配置(所有 Master 节点相同)
export SPARK_DAEMON_JAVA_OPTS="
  -Dspark.deploy.recoveryMode=ZOOKEEPER
  -Dspark.deploy.zookeeper.url=zk1:2181,zk2:2181,zk3:2181
  -Dspark.deploy.zookeeper.dir=/spark_master
"
4.2 启动集群
# === ZK 集群(先启动)===
zkServer.sh start  # 所有 ZK 节点

# === Master 节点 ===
$SPARK_HOME/sbin/start-master.sh    # master-1 (Active)
$SPARK_HOME/sbin/start-master.sh    # master-2 (Standby)
$SPARK_HOME/sbin/start-master.sh    # master-3 (Standby)

# === Worker 节点 ===
# 指向所有 Master 地址以自动发现 Active
$SPARK_HOME/sbin/start-worker.sh spark://master-1:7077,master-2:7077,master-3:7077
4.3 验证 HA 状态
# 查看 Active Master
curl http://master-1:8080/json/ | python3 -m json.tool | grep status

# ZK 中查看选主状态
zkCli.sh -server zk1:2181
ls /spark_master/leader_election            # 临时节点列表
get /spark_master/status                     # Active Master 地址

# 模拟 Failover:停掉 Active Master
kill $(jps | grep Master | awk '{print $1}')
# → 观察 Standby 在 30s 内自动接管
五、核心源码追踪
ZooKeeperLeaderElectionAgent
// 源码: org.apache.spark.deploy.master.ZooKeeperLeaderElectionAgent
class ZooKeeperLeaderElectionAgent(val master: LeaderElectable,
    conf: SparkConf) extends LeaderElectionAgent {

  val WORKING_DIR = conf.get(ZOOKEEPER_DIRECTORY) + "/leader_election"
  // 创建临时顺序节点
  val znode = zk.create(WORKING_DIR + "/member_",
    master.address.getBytes, ZooDefs.Ids.OPEN_ACL_UNSAFE,
    CreateMode.EPHEMERAL_SEQUENTIAL)

  // 获取所有候选节点,排序后最小的为 Leader
  def updateLeader(): Unit = {
    val children = zk.getChildren(WORKING_DIR, true).sorted
    val masterAddress = zk.getData(WORKING_DIR + "/" + children.head)
    master.electedLeader()   // 或 master.revokedLeadership()
  }
}
PersistenceEngine 接口
// 源码: org.apache.spark.deploy.master.PersistenceEngine
trait PersistenceEngine {
  def persist(name: String, obj: Object): Unit         // 持久化
  def unpersist(name: String): Unit                     // 删除
  def read[T: ClassTag](prefix: String): Seq[T]          // 读取所有

  // 内置实现:
  // ZooKeeperPersistenceEngine  → 写入 ZK ZNodes
  // FileSystemPersistenceEngine → 写入本地/HDFS 文件
  // BlackHolePersistenceEngine  → 丢弃所有数据(NONE 模式)
}
六、总结
Master HA 核心:多 Master + ZK 临时顺序节点选主。Active 负责全部调度工作并写 PersistenceEngine;Standby 只读等待接管,通过 ZK Watcher 感知 Leader 变更。
三种恢复模式:
ZOOKEEPER(生产首选,完整 HA)、FILESYSTEM(单节点恢复,非真正 HA)、NONE(默认,仅限开发)。配置要点:所有 Master 共享相同
spark.deploy.zookeeper.url和spark.deploy.zookeeper.dir;Worker 和 Client 指向所有 Master 地址以自动发现 Active。
作者:starzy
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践