
SparkSQL 之 Json 格式数据转 DataSet 代码实现
摘要:JSON 是数据工程中最常见的半结构化格式,如何高效地将 JSON 转为类型安全的 Dataset[CaseClass]?本文从 spark.read.json() 的三种数据源、Schema 推断 vs 手动指定的优劣对比、嵌套 JSON 的三种展平模式(Dot Notation / explode / from_json)、以及 Encoder[CaseClass] 映射四个维度,配合 2 张架构图 + 完整代码实例,覆盖 Json Options 全部配置项,给出生产级的 JSON→Dataset 转换实践。
关键词:spark.read.json, Schema 推断, explode, from_json, Encoder, CaseClass, Nested JSON, Json Options
一、开篇:JSON→Dataset 的正确姿势
JSON → Dataset 三大核心问题
① Schema: 自动推断 vs 手动指定 → 性能&精确度权衡
② Nested: Struct/Array/Map 嵌套字段如何展平
③ Encoding: Row → CaseClass 的类型安全映射
二、JSON → DataFrame/Dataset 转换流程
图 1:三种 JSON 数据源 → Schema 推断/手动 → DataFrame/Dataset 全景流程
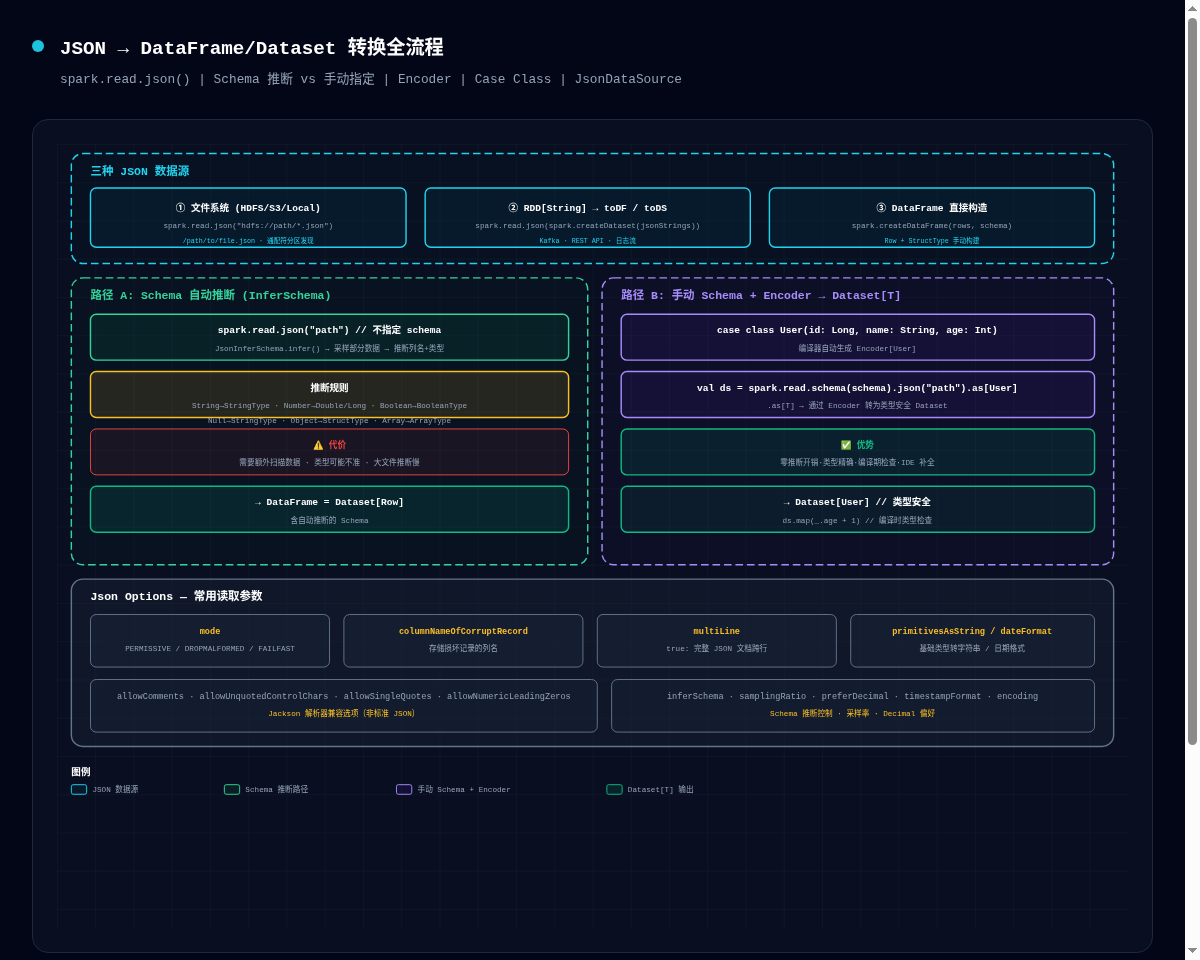
2.1 三种数据源入口
// ① 文件系统(最常用)
val df = spark.read.json("hdfs://data/events/2024/*.json")
val df = spark.read.json("/local/path/file.json")

// ② RDD[String] → DataFrame
val jsonStrings: Dataset[String] = spark.createDataset(Seq(
  """{"id":1,"name":"张三"}""",
  """{"id":2,"name":"李四"}"""))
val df = spark.read.json(jsonStrings)

// ③ DataFrame 直接构建
val schema = StructType(Seq(
  StructField("id", LongType),
  StructField("name", StringType)))
val df = spark.createDataFrame(rows, schema)
2.2 Schema 推断 vs 手动指定
// 方式 A: 自动推断(方便但慢)
val df = spark.read
  .option("inferSchema", "true")
  .option("samplingRatio", "0.1")
  .json("path")

// 方式 B: 手动 Schema(推荐)
val schema = StructType(Seq(
  StructField("id", LongType),
  StructField("name", StringType),
  StructField("age", IntegerType)))
val df = spark.read.schema(schema).json("path")
// ✅ 零推断开销 · 类型精确 · 不依赖采样
三、嵌套 JSON 展平三大模式
图 2:嵌套 JSON → Dot Notation / explode / from_json 三种展平模式 + Dataset 映射
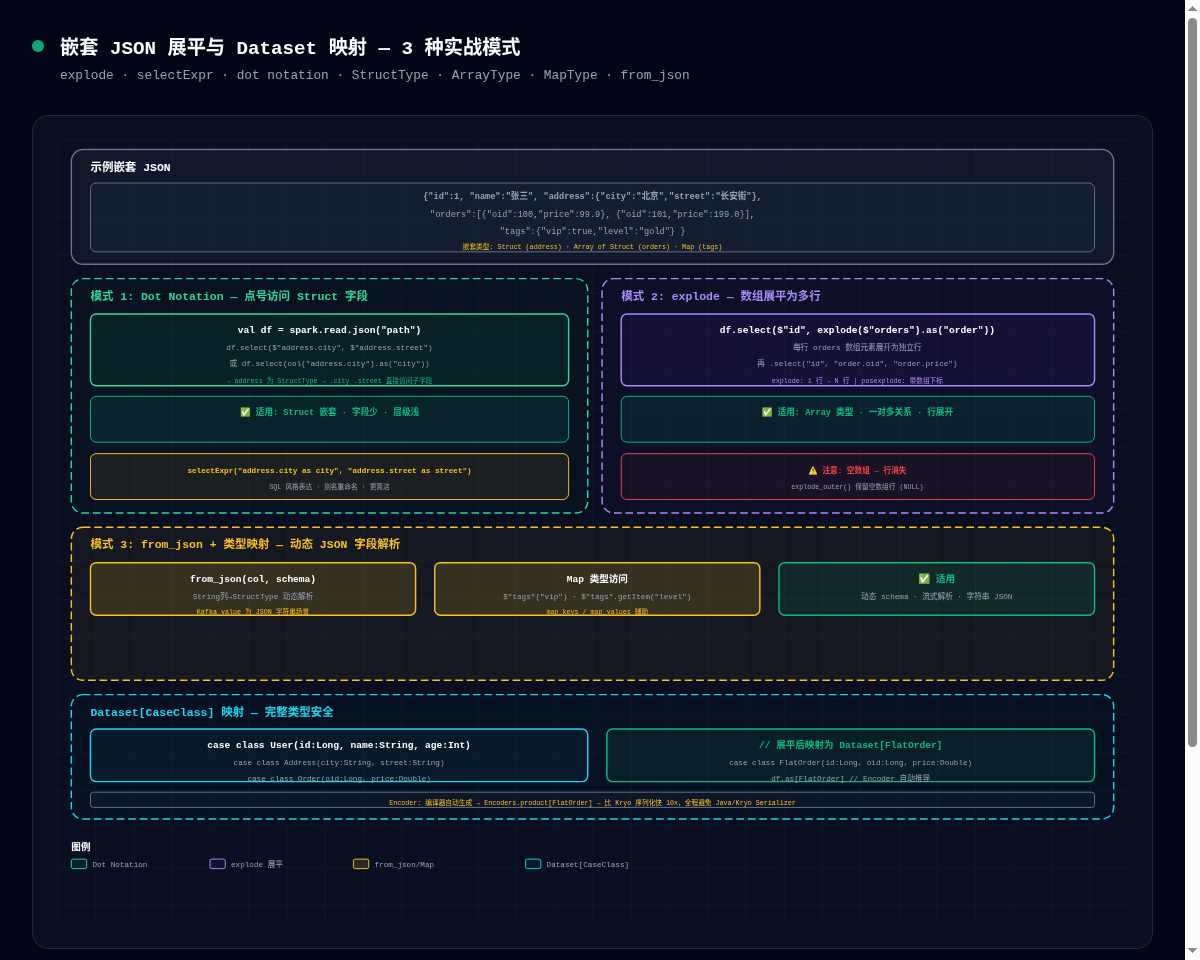
3.1 Dot Notation — Struct 字段访问
val flat = df.select(
  $"id", $"name",
  $"address.city".as("city"),
  $"address.street".as("street"))
// 或用 selectExpr SQL 风格
val flat = df.selectExpr("id", "name",
  "address.city as city", "address.street as street")
3.2 explode — Array 数组展平(1行→N行)
val exploded = df
  .select($"id", $"name", explode($"orders").as("order"))
  .select($"id", $"name", $"order.oid", $"order.price")

// explode_outer: 保留空数组行
// posexplode: 额外输出数组下标
3.3 from_json — 动态解析 JSON 字符串
import org.apache.spark.sql.functions.from_json

val orderSchema = StructType(Seq(
  StructField("oid", LongType),
  StructField("price", DoubleType)))

df.select($"id",
  from_json($"jsonStrCol", orderSchema).as("parsed"))
  .select($"id", $"parsed.oid", $"parsed.price")
四、Dataset[CaseClass] 类型安全映射
case class User(id: Long, name: String, age: Int)
case class FlatOrder(id: Long, name: String, oid: Long, price: Double)

val ds: Dataset[FlatOrder] = df
  .select($"id", $"name", explode($"orders").as("order"))
  .select($"id", $"name", $"order.oid", $"order.price")
  .as[FlatOrder]  // Encoder 自动推导

// 类型安全操作
ds.filter(_.price > 100).map(o => o.copy(price = o.price * 1.1))
五、Json Options 速查
| 类别 | 参数 | 说明 |
|---|---|---|
| 损坏处理 | mode=PERMISSIVE/DROPMALFORMED/FAILFAST | 损坏行处理策略 |
| 格式 | multiLine / allowComments / allowSingleQuotes | 非标准 JSON 兼容 |
| 类型 | primitivesAsString / preferDecimal | 推断控制 |
| 日期 | dateFormat / timestampFormat | 日期解析 |
| 性能 | inferSchema / samplingRatio | 推断开销控制 |
六、总结
Schema 策略:手动 Schema 比自动推断更快更精确,生产环境推荐
.schema(structType)。嵌套展平三模式:Dot Notation(Struct) → explode(Array) → from_json(String JSON)。
Dataset[CaseClass]:通过
.as[T]获得编译时类型安全,Encoder 比 Kryo 快 10x。
作者:starzy
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践