
Spark 核心之 Cluster 模式提交命令和特点分析
摘要:这是 Spark 部署模式系列的终章。如果说 Client 模式是你手中的风筝,Cluster 模式就是放飞到云端的无人机——spark-submit 提交后即可退出,Driver 在集群中独立运行。本文从 Standalone-Cluster 与 YARN-Cluster 命令对比、--supervise 与 maxAppAttempts 的 HA 机制、六大核心差异、日志查看四件套、四种生产场景模板五个维度,配合 1 张原创深色架构图和完整可运行示例,助你彻底掌握 Spark Cluster 模式的提交命令。
关键词:spark-submit, Cluster 模式, --deploy-mode cluster, --supervise, Standalone-Cluster, YARN-Cluster, yarn logs, Driver HA
一、开篇:Cluster 模式的终极价值
前文我们详细对比了 Client 模式的 Standalone/YARN 提交命令。但如果你要运行的是一个需要跑 3 小时的生产 ETL 任务,Client 模式有一个致命问题:
spark-submit 进程不能退出——你的笔记本合上盖子,任务就中断了。
Cluster 模式正是为了解决这个问题而设计:
bash
# Cluster 模式提交完即可退出
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --executor-memory 8G \
  --num-executors 20 \
  etl-job.jar
# ← 提交完成,进程退出
# ← 任务在 YARN 集群中继续运行
# ← 你可以关电脑了
二、Cluster 模式命令全景图
图 1:Spark Cluster 模式 spark-submit 命令全景图
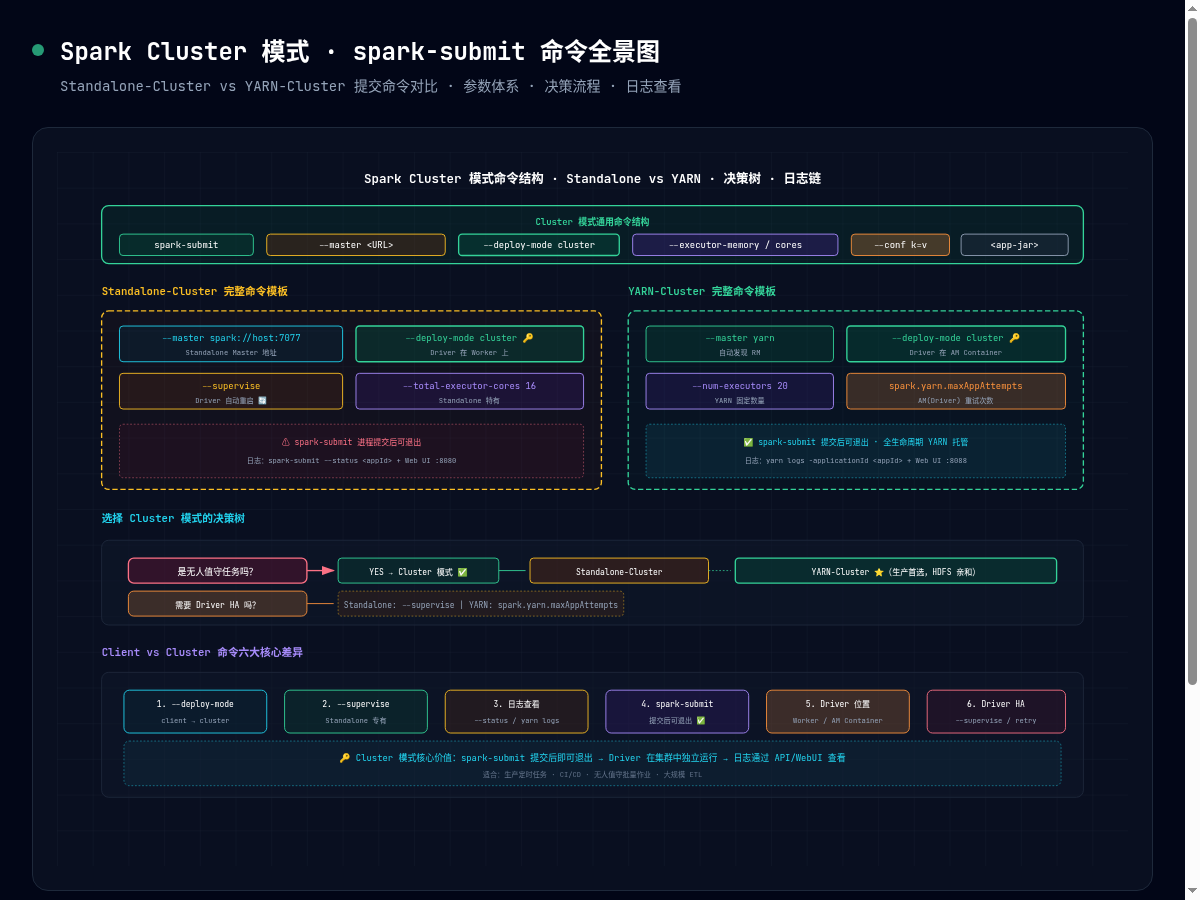
2.1 通用结构
bash
spark-submit \
  --master <URL> \
  --deploy-mode cluster \       # 🔑 核心区别
  [--supervise] \               # Standalone 专有
  [--driver-*] \                # Driver 资源配置
  [--executor-*] \              # Executor 资源配置
  [--conf k=v] \                # 动态配置
  <app-jar> [app-args]
2.2 --deploy-mode cluster 的语义
将 --deploy-mode 从 client 改为 cluster,意味着:
| 维度 | Client | Cluster |
|---|---|---|
| Driver 位置 | 提交客户端 JVM | Standalone: Worker 节点 / YARN: AM Container |
| spark-submit | 必须全程存活 | 提交后可退出 |
| 日志查看 | 控制台直接可见 | --status / yarn logs / Web UI |
| Driver HA | ❌ | ✅ --supervise / maxAppAttempts |
三、Standalone-Cluster 命令
3.1 完整模板
bash
spark-submit \
  --master spark://master-node:7077 \
  --deploy-mode cluster \
  --supervise \
  --class com.example.SparkApp \
  --name "my-cluster-app" \
  --driver-memory 2G \
  --driver-cores 1 \
  --executor-memory 4G \
  --executor-cores 2 \
  --total-executor-cores 16 \
  --conf spark.driver.supervise=true \
  --conf spark.eventLog.enabled=true \
  --conf spark.eventLog.dir=hdfs:///spark-logs \
  /path/to/my-app.jar
3.2 --supervise 详解
| 场景 | --supervise 行为 |
|---|---|
| Driver OOM | Master 重新调度到 Worker |
| Worker 节点宕机 | Master 调度到其他 Worker |
| 代码确定性 Bug | ⚠️ 无限重启(需人工介入) |
| 不指定 --supervise | Driver 挂了 = 应用永久失败 |
bash
# 查看应用状态
spark-submit --master spark://master:7077 --status <appId>

# 通过 Web UI 查看 Driver 日志
# http://master:8080 → 应用详情 → stdout/stderr
四、YARN-Cluster 命令
4.1 完整模板
bash
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --class com.example.SparkApp \
  --name "my-yarn-cluster-app" \
  --driver-memory 2G \
  --driver-cores 1 \
  --executor-memory 8G \
  --executor-cores 4 \
  --num-executors 20 \
  --conf spark.yarn.am.memory=2G \
  --conf spark.yarn.queue=production \
  --conf spark.yarn.maxAppAttempts=3 \
  --conf spark.eventLog.enabled=true \
  --conf spark.eventLog.dir=hdfs:///spark-logs \
  /path/to/my-app.jar
# ← spark-submit 立即退出 ✅
4.2 YARN-Cluster 日志四件套
| 方式 | 命令 | 适用场景 |
|---|---|---|
| yarn logs | yarn logs -applicationId <appId> | 完整日志拉取 |
| AM 日志 | yarn logs -appId <id> -containerId <amId> | Driver 日志 |
| Web UI | http://rm-host:8088 | 实时监控 |
| HDFS 日志 | hdfs dfs -cat /spark-logs/<appId> | 持久化审计 |
bash
# 快速查看 Driver(AM) 日志
yarn logs -applicationId application_1234567890_0001 \
  | grep -A 20 "ERROR\|Exception\|FAILED"
五、Standalone-Cluster vs YARN-Cluster 命令速记
bash
# ===== Standalone-Cluster =====
spark-submit \
  --master spark://master:7077 \
  --deploy-mode cluster \
  --supervise \                   # ← Driver 自动重启
  --total-executor-cores 16 \
  app.jar
# 日志:--status + Web UI :8080

# ===== YARN-Cluster =====
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --num-executors 20 \            # ← 固定 Container 数
  --conf spark.yarn.maxAppAttempts=3 \  # ← AM 重试
  --conf spark.yarn.queue=production \
  app.jar
# 日志:yarn logs + Web UI :8088| 维度 | Standalone-Cluster | YARN-Cluster |
|---|---|---|
| --master | spark://host:7077 | yarn |
| HA 参数 | --supervise | spark.yarn.maxAppAttempts |
| 资源指定 | --total-executor-cores | --num-executors |
| 日志查看 | --status + Web UI | yarn logs + Web UI |
| 队列管理 | ❌ | spark.yarn.queue |
六、Client vs Cluster 命令六大差异
| # | 维度 | Client | Cluster |
|---|---|---|---|
| 1 | --deploy-mode | client | cluster |
| 2 | spark-submit 生命周期 | 全程存活 | 提交后可退出 |
| 3 | Driver 位置 | 提交客户端 | Worker / AM Container |
| 4 | Driver HA | ❌ | ✅ --supervise / maxAppAttempts |
| 5 | 日志查看 | 控制台 | --status / yarn logs |
| 6 | 运维友好度 | 开发调试专用 | 生产首选 |
七、四种生产场景模板
场景 1:Standalone 集群定时任务
bash
spark-submit \
  --master spark://master:7077 \
  --deploy-mode cluster \
  --supervise \
  --driver-memory 2G \
  --executor-memory 4G \
  --total-executor-cores 16 \
  daily-report.jar
场景 2:YARN 集群大规模 ETL
bash
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --driver-memory 4G \
  --executor-memory 8G \
  --executor-cores 4 \
  --num-executors 40 \
  --conf spark.yarn.queue=production \
  --conf spark.sql.shuffle.partitions=800 \
  etl-pipeline.jar 2025-01-01
场景 3:PySpark ML Pipeline
bash
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --executor-memory 4G \
  --num-executors 16 \
  --conf spark.pyspark.python=/usr/bin/python3 \
  --conf spark.dynamicAllocation.enabled=true \
  ml-training.py --input hdfs:///data/train
场景 4:CI/CD 流水线集成
bash
# Jenkins / GitLab CI 中
APP_ID=$(spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --executor-memory 4G \
  --num-executors 8 \
  integration-test.jar 2>&1 | grep "Submitted application" | awk '{print $NF}')

echo "App ID: $APP_ID"

# 轮询等待完成
while true; do
  STATE=$(yarn application -status $APP_ID | grep "Final-State" | awk '{print $NF}')
  if [ "$STATE" != "UNDEFINED" ]; then
    echo "Final State: $STATE"
    yarn logs -applicationId $APP_ID > test-logs.txt
    break
  fi
  sleep 30
done
八、总结
| 要点 | 一句话总结 |
|---|---|
| --deploy-mode | cluster 让 Driver 运行在集群中,spark-submit 可退出 |
| HA 机制 | Standalone 用 --supervise,YARN 用 maxAppAttempts |
| 日志 | Standalone 用 --status,YARN 用 yarn logs |
| 生产首选 | YARN-Cluster = 资源隔离 + 多租户 + HDFS 亲和 + Driver HA |
金句:
--deploy-mode cluster不是参数的改变,而是运维哲学的升级——从"我盯着任务跑完"到"我提交完就走了"。