
Spark 核心之 Standalone-Cluster 模式:原理、流程与源码级深度拆解
摘要:如果说 Client 模式是开发者的"调试利器",那么 Cluster 模式就是生产环境的"定海神针"。Driver 不再运行在你的笔记本上,而是被 Master 调度到集群 Worker 节点——spark-submit 提交完即可退出,应用完全脱离客户端独立运行。本文从整体架构、11 步启动流程、ClientApp 短连接机制、supervise 自动重启四个维度,配合 2 张原创深色架构图和完整源码分析,带你彻底吃透 Standalone-Cluster 模式的每一个细节。
关键词:Spark Standalone, Cluster 模式, DriverWrapper, ClientApp, Master, Worker, Executor, supervise, 生产环境调度
一、开篇:为什么你需要 Cluster 模式?
在上一篇文章中,我们深度拆解了 Client 模式。如果你还记得的话,Client 模式有一个致命缺陷:
spark-submit 进程不能退出——因为它就是 Driver。
这意味着:
- 你的笔记本合上盖子 → 任务中断
- 网络断开 → 任务中断
- 终端被关闭 → 任务中断
在生产环境、定时任务、CI/CD 流水线中,这是完全不可接受的。
# Cluster 模式:提交完即可退出
spark-submit \
  --master spark://master:7077 \
  --deploy-mode cluster \
  --supervise \
  --executor-memory 4G \
  --total-executor-cores 8 \
  my-app.jar
# ← 提交完成后 spark-submit 进程立即退出
# ← Driver 在集群 Worker 节点上独立运行
# ← 你的笔记本可以关机了
Cluster 模式的核心哲学是:将 Driver 的运行也交给集群管理,实现完全的去客户端化。本文将详细讲解这一模式的设计原理、启动流程和最佳实践。
二、Cluster 模式整体架构
2.1 角色模型
Cluster 模式新增了一个关键角色——ClientApp,同时改变了 Driver 的生命周期管理模式:
| 角色 | Client 模式位置 | Cluster 模式位置 | 核心变化 |
|---|---|---|---|
| spark-submit | 就是 Driver,必须存活 | 短连接,提交后退出 | 🔥 最核心区别 |
| ClientApp | 不存在 | spark-submit fork 的子进程 | 负责注册 + 等待结果 |
| Driver | 提交客户端 JVM | Worker 节点上的 DriverWrapper | 🔑 位置迁移 |
| Master | 资源调度 | 资源调度 + Driver 调度 | 新增 Driver 调度 |
| Worker | 启动 Executor | 启动 DriverWrapper + Executor | 新增 Driver 托管 |
| Executor | Worker 子进程 | Worker 子进程(同 Client) | 无变化 |
2.2 整体架构图
图 1:Spark Standalone Cluster 模式整体架构
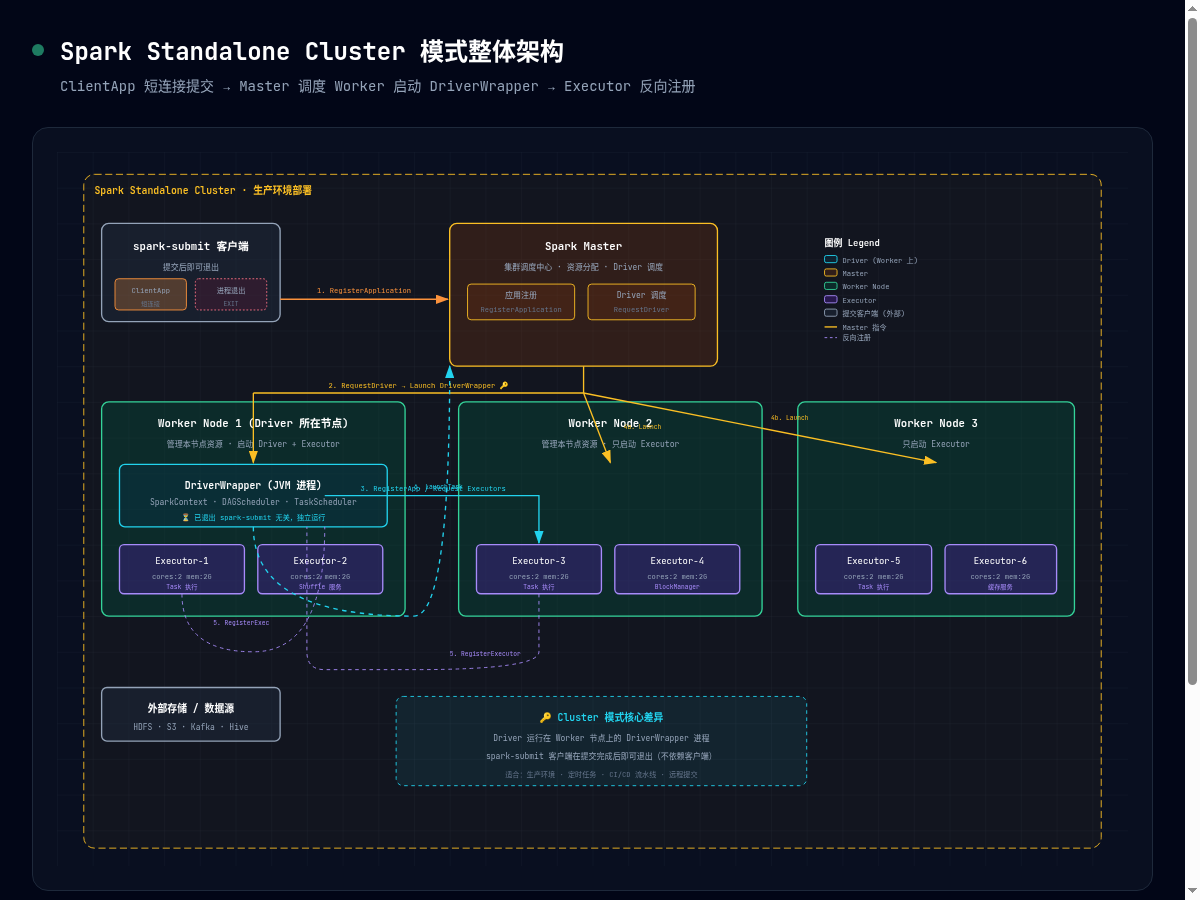
三个关键设计要点:
ClientApp 是短连接进程:它只负责向 Master 注册应用、等待 Driver 启动成功,收到成功通知后立即退出。与之对应,Client 模式的 spark-submit 需要全程存活。
DriverWrapper 是 Worker 托管进程:Master 选择一个满足条件的 Worker,指令其 fork 出 DriverWrapper JVM 进程。这个进程内部初始化 SparkContext,扮演 Driver 角色。
spark-submit → ClientApp → Master → Worker → DriverWrapper 是一条完整的责任链,任何一环失败都会导致应用提交失败。
三、Cluster 模式 vs Client 模式:一张表彻底搞清
| 对比维度 | Client 模式 | Cluster 模式 |
|---|---|---|
| Driver 运行位置 | 提交客户端 JVM | Worker 节点 DriverWrapper JVM |
| spark-submit 生命周期 | 贯穿整个 Job | 提交后立即退出 |
| 中间代理 | 无(直接创建 SparkContext) | ClientApp 子进程 |
| 日志查看 | 控制台直接可见 | spark-submit --status 或 Web UI |
| 网络要求 | Driver ↔ 全部 Executor 互通 | 集群内部闭环,不需要客户端连通 |
| Driver HA | 不支持(客户端挂了就是挂了) | 支持 --supervise 自动重启 |
| 适用场景 | 开发调试、交互式分析 | 生产环境、定时任务、CI/CD |
| 提交方式 | spark-shell / spark-submit --deploy-mode client | spark-submit --deploy-mode cluster |
四、Cluster 模式启动流程:12 步深度拆解
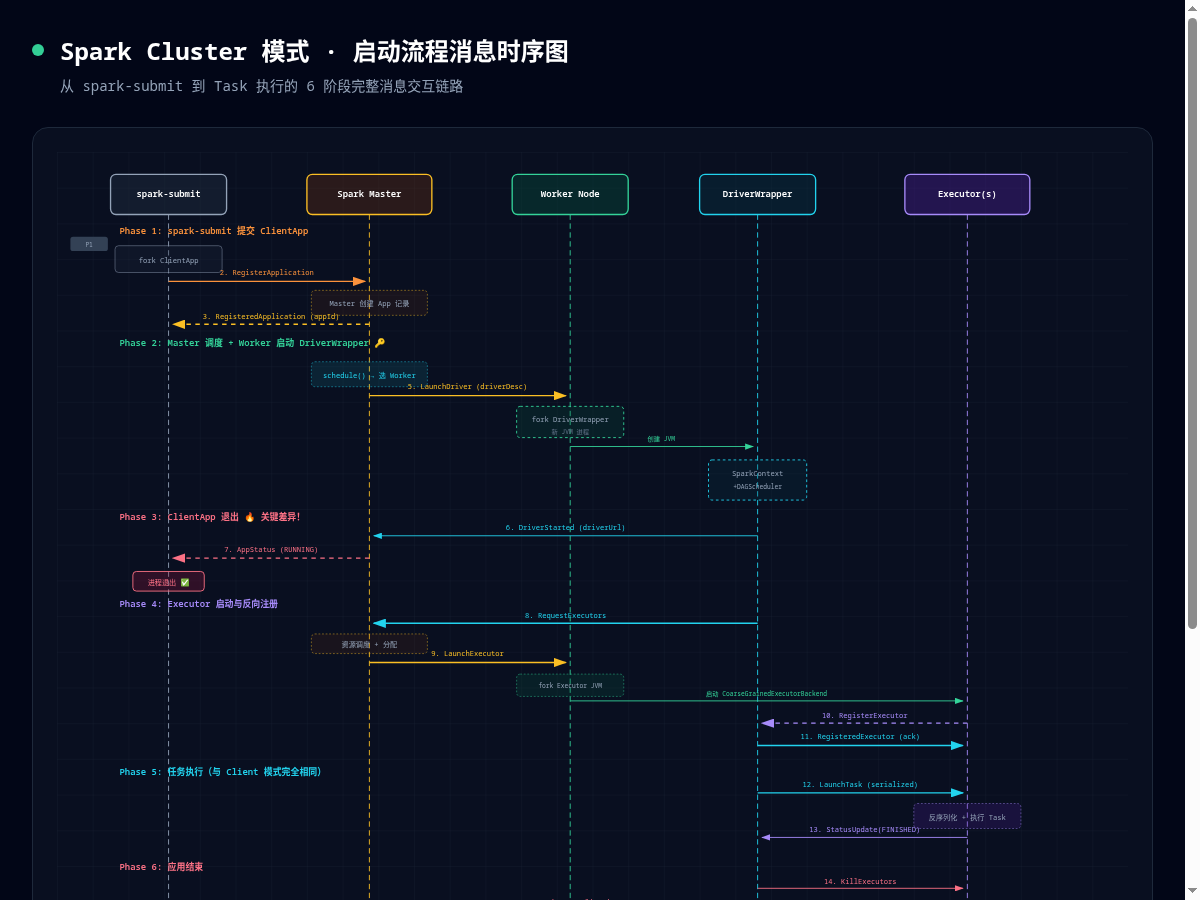
这是本文最核心的章节。我们用一张完整的消息时序图 + 12 步源码追踪来拆解。
图 2:Cluster 模式启动流程消息时序图(6 Phase × 15 消息)
4.1 Phase 1:spark-submit fork ClientApp
Step 1 — spark-submit 判断 deployMode
// 源码:SparkSubmit.scala
if (args.isStandaloneCluster) {
  // ===== Cluster 模式:fork ClientApp 子进程 =====
  runMainRestOrChild(args, childArgs, childClasspath, ...)
} else {
  // ===== Client 模式:直接在当前 JVM 运行 main =====
  runMainChild(args, childArgs, childClasspath, ...)
}
Cluster 模式下,SparkSubmit 不直接创建 SparkContext。它 fork 出一个 ClientApp 子进程。
Step 2 — ClientApp 向 Master 注册
// 源码:StandaloneAppClient.scala
class ClientEndpoint extends ThreadSafeRpcEndpoint {
  override def onStart(): Unit = {
    // 向 Master 发送 RegisterApplication
    registerMasterFutures = tryRegisterAllMasters()
  }

  private def tryRegisterAllMasters() = {
    masterRpcAddresses.map { addr =>
      rpcEnv.setupEndpointRef(addr, Master.ENDPOINT_NAME)
        .ask[RegisterApplicationResponse](
          RegisterApplication(appDescription, self))
    }
  }
}
4.2 Phase 2:Master 调度 + 启动 DriverWrapper 🔑
这是 Cluster 模式最核心的独有逻辑。
Step 3 — Master 调度 Driver
// 源码:Master.scala - schedule() 方法中的 Driver 调度逻辑
private def schedule(): Unit = {
  // ... 先调度 Executor 的资源 ...

  // ===== Cluster 模式特有:调度 Driver =====
  for (driver <- waitingDrivers.toList) {
    // 筛选可用 Worker(满足 driver.desc.mem + driver.desc.cores)
    val worker = workers.filter(_.state == WorkerState.ALIVE)
      .filter(canLaunchDriver(_, driver.desc))
      .headOption

    worker.foreach { w =>
      // 从等待队列移除
      waitingDrivers -= driver
      // 指令 Worker 启动 DriverWrapper
      w.endpoint.send(LaunchDriver(driver.id, driver.desc))
      driver.state = DriverState.RUNNING
    }
  }
}关键点:Master 会像调度 Executor 一样调度 Driver——选择一个资源充足的 Worker,分配 CPU 和内存,然后指令其启动。
Step 4 — Worker fork DriverWrapper JVM 进程
Worker 收到 LaunchDriver 消息后,fork 出一个新的 JVM 进程运行 DriverWrapper:
# Worker 内部等价命令
java -cp spark-assembly.jar \
  org.apache.spark.deploy.worker.DriverWrapper \
  spark://worker:PORT \
  <user-main-class> \
  <user-main-args>
Step 5 — DriverWrapper 内部初始化 SparkContext
// 源码:DriverWrapper.scala
object DriverWrapper {
  def main(args: Array[String]): Unit = {
    // 解析用户 main class
    val mainClass = Class.forName(args(1))
    val mainMethod = mainClass.getMethod("main", classOf[Array[String]])

    // 在 DriverWrapper JVM 中执行用户 main 方法
    // 用户代码中的 new SparkContext(...) 会在此 JVM 中初始化
    mainMethod.invoke(null, userArgs)
    // SparkContext 创建完毕 → Driver 就绪
  }
}
Step 6 — Driver 反向通知 Master
Driver 启动完成后,通过 RPC 通知 Master:
// Master 收到 DriverStateChanged
case DriverStateChanged(driverId, state, exception) =>
  state match {
    case DriverState.RUNNING | DriverState.FINISHED | ...
      // 通知 ClientApp:Driver 已就绪
      driver.appClient.foreach(_.send(DriverStateChanged(...)))
  }
4.3 Phase 3:ClientApp 收到成功通知 → 退出 🔥
这是 Cluster 模式和 Client 模式最本质的分水岭!
Step 7 — Master 通知 ClientApp
Master 将 DriverState.RUNNING 状态推送给 ClientApp。
Step 8 — ClientApp 打印结果 → 退出
// ClientApp 收到 Driver 启动成功
case DriverStateChanged(driverId, DriverState.RUNNING, _) =>
  logInfo(s"Driver successfully started on ${driver.worker}")
  // 打印 Driver URL 供用户查看日志
  // → 进程退出!
System.exit(0)# 用户终端看到的输出
$ spark-submit --deploy-mode cluster ... my-app.jar
...
INFO ClientApp: Driver successfully started on worker-1:38372
$ echo $?
0
# ← spark-submit 进程已经退出了!
# ← 但应用在集群中继续运行!4.4 Phase 4-6:后续流程(与 Client 模式相同)
Driver 就绪后,后续的 Executor 启动、Task 执行、结果回传等流程与 Client 模式完全相同:
Phase 4: Driver → Master: RequestExecutors
         Master → Worker: LaunchExecutor
         Executor → Driver: RegisterExecutor (反向注册)

Phase 5: Driver → Executor: LaunchTask
         Executor → Driver: StatusUpdate(FINISHED)

Phase 6: Driver → Executor: KillExecutors
         Driver → Master: UnregisterApplication
五、--supervise 参数:Driver 自动重启机制
Cluster 模式独有的 --supervise 参数让 Driver 具备了自动重启能力:
spark-submit \
  --master spark://master:7077 \
  --deploy-mode cluster \
  --supervise \            # 🔑 开启 Driver 自动重启
  --executor-memory 4G \
  my-app.jar
5.1 工作原理
// 源码:Master.scala - 处理 Driver 状态变更
case DriverStateChanged(driverId, DriverState.FAILED, Some(exception)) =>
  drivers.find(_.id == driverId).foreach { driver =>
    if (driver.desc.supervise) {
      logInfo(s"Driver $driverId failed, will restart it")
      // 重新加入等待队列,触发重新调度
      waitingDrivers += driver
    } else {
      logInfo(s"Driver $driverId failed, removing it")
      removeDriver(driver, DriverState.FAILED, Some(exception))
    }
  }
5.2 适用场景与限制
| 场景 | 是否适用 | 原因 |
|---|---|---|
| Driver OOM | ✅ 适用 | 重启后恢复 |
| 代码 Bug(确定性错误) | ❌ 不适用 | 重启后再次失败,死循环 |
| 节点宕机 | ✅ 适用 | Master 会重新调度到其他 Worker |
| 外部资源不可用 | ❌ 不适用 | 重启无法解决 |
六、生产环境最佳实践
6.1 模式选择决策
# 开发调试 → Client 模式
spark-shell --master spark://master:7077
# 等价于 --deploy-mode client

# 生产定时任务 → Cluster 模式
spark-submit \
  --master spark://master:7077 \
  --deploy-mode cluster \
  --supervise \
  --driver-memory 4G \
  --executor-memory 8G \
  --total-executor-cores 16 \
  /path/to/prod-job.jar
6.2 常见故障排查
故障 1:Cluster 模式提交后看不到日志
# 获取应用状态
spark-submit --master spark://master:7077 --status <appId>

# 通过 Web UI 查看
# http://master:8080 → 点击对应应用 → Executors 标签 → stdout/stderr

# 配置日志聚合到 HDFS
--conf spark.eventLog.enabled=true
--conf spark.eventLog.dir=hdfs://namenode:8020/spark-logs
故障 2:Driver 调度失败 - 没有 Worker 满足条件
WARN Master: Driver <appId> requires more resources than any of our workers have解决:
- 检查
--driver-memory是否超过 Worker 可用内存 - 检查
--driver-cores是否超过 Worker 可用核心 - 确认 Worker 节点注册正常
故障 3:--supervise 模式下 Driver 无限重启
详见 5.2 的适用场景分析。对于确定性错误(代码 Bug),需要修复代码后重新提交。
七、总结
核心知识速记
| 要点 | 一句话总结 |
|---|---|
| Driver 位置 | Cluster 在 Worker 节点 DriverWrapper,Client 在提交客户端 |
| ClientApp | Cluster 专属短连接代理,负责注册 + 等待结果后退出 |
| spark-submit | Cluster 模式提交后退出;Client 模式全程存活 |
| --supervise | Cluster 专属 Driver 自动重启,确定性 Bug 不适用 |
| 启动链路 | spark-submit → ClientApp → Master → Worker → DriverWrapper |
| 后续流程 | Driver 就绪后与 Client 模式完全相同 |
金句:Cluster 模式让 Driver 成为集群的一等公民——它不再是你笔记本上的临时进程,而是受 Master 管理、Worker 托管的生产级服务。