
Spark 核心之 RDD 窄依赖与宽依赖详解
摘要:为什么
map().filter()可以在一个 Stage 内完成,而reduceByKey()必须切分新的 Stage?为什么 Shuffle 是 Spark 性能的头号杀手?答案就在 RDD 的依赖类型之中——NarrowDependency 与 ShuffleDependency。本文从依赖类型体系、Stage 边界判定源码、Pipeline 优化原理、容错策略差异、性能影响与调优五个维度,配合 1 张原创深色架构图 + 完整源码分析,带你彻底理解 Spark 最核心的概念之一。关键词:Spark RDD, NarrowDependency, ShuffleDependency, Stage, Pipeline, 血缘, 容错, Shuffle
一、开篇:为什么依赖类型决定一切?
先看两段等价代码:
// 方案 A: 全 Narrow — 1 个 Stage, 无 Shuffle
rdd.map(_ + 1).filter(_ > 10).collect()

// 方案 B: 包含 Wide — 2 个 Stage, 有 Shuffle
rdd.map(_ + 1).reduceByKey(_ + _).collect()
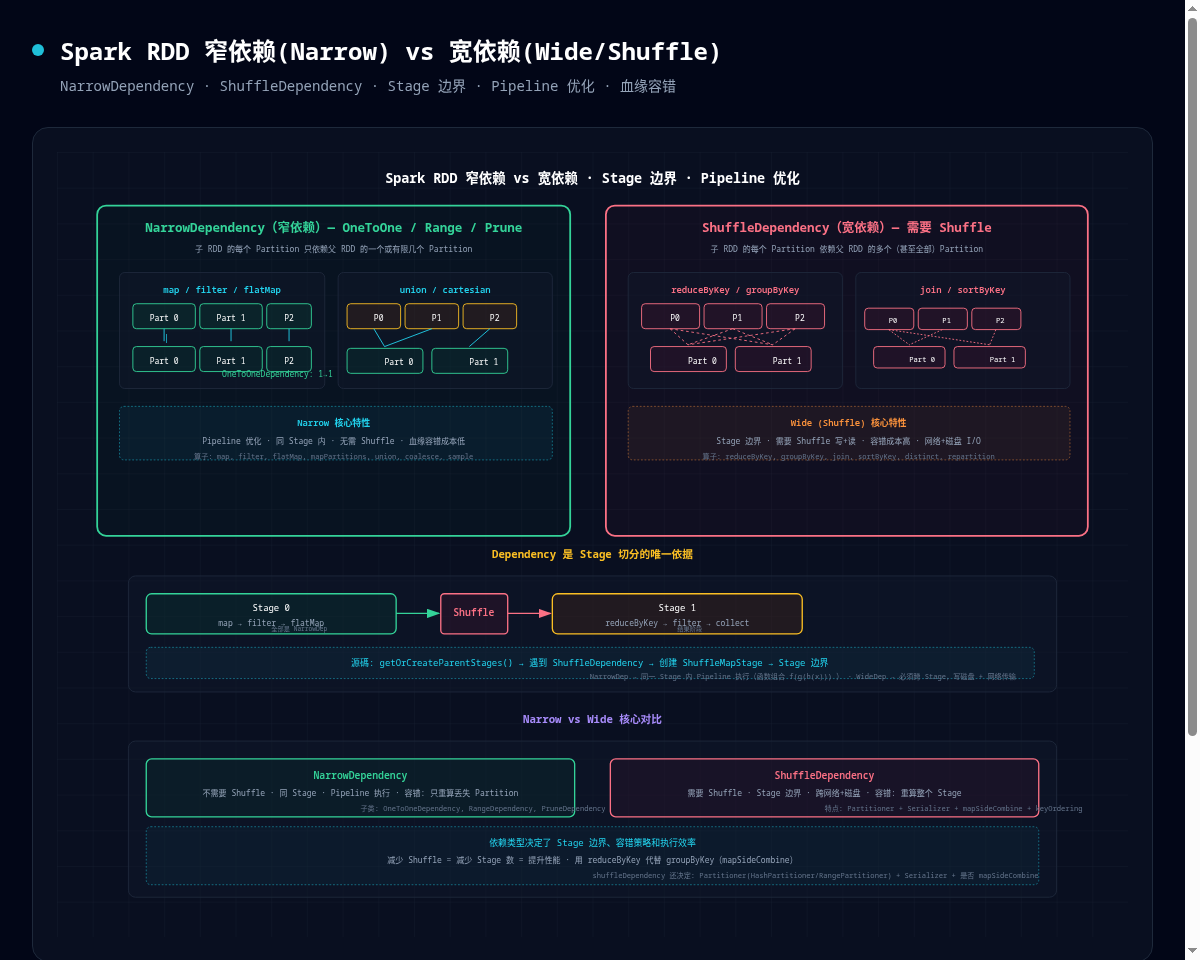
方案 A 只有 1 个 Stage,因为 map 和 filter 都是窄依赖——子 Partition 只依赖父 Partition 的 1 对 1 映射,Spark 可以将它们 Pipeline 在一起 执行。
方案 B 有 2 个 Stage,因为 reduceByKey 是宽依赖——子 Partition 需要从多个父 Partition 拉取数据,必须通过 Shuffle 重新分区。
二、NarrowDependency vs ShuffleDependency 全景图
图 1:Spark RDD 窄依赖 vs 宽依赖全景对比
三、NarrowDependency(窄依赖)
3.1 三种子类型
// 源码:Dependency.scala
abstract class NarrowDependency[T](_rdd: RDD[T]) extends Dependency[T] {
  // 子 Partition 依赖父 RDD 的哪些 Partition
  def getParents(partitionId: Int): Seq[Int]
}

// 1:1 映射
class OneToOneDependency[T](rdd: RDD[T]) extends NarrowDependency[T](rdd) {
  override def getParents(partitionId: Int) = List(partitionId)
}

// Range 依赖 (union)
class RangeDependency[T](rdd: RDD[T], inStart: Int, outStart: Int, length: Int)
  extends NarrowDependency[T](rdd) {
  override def getParents(partitionId: Int) =
    if (partitionId >= outStart && partitionId < outStart + length)
      List(partitionId - outStart + inStart) else Nil
}
3.2 哪些算子产生 NarrowDependency?
| 算子 | 依赖类型 | 说明 |
|---|---|---|
map | OneToOneDependency | 1→1 映射 |
filter | OneToOneDependency | 1→1 映射(过滤后仍独立) |
flatMap | OneToOneDependency | 1→1 映射 |
mapPartitions | OneToOneDependency | 1→1 映射 |
union | RangeDependency | 多 RDD 拼接 |
coalesce | NarrowDependency | 减少 Partition(不涉及 Shuffle 时) |
sample | OneToOneDependency | 采样 |
四、ShuffleDependency(宽依赖)
4.1 源码结构
class ShuffleDependency[K, V, C](
    @transient private val _rdd: RDD[_ <: Product2[K, V]],
    val partitioner: Partitioner,        // HashPartitioner / RangePartitioner
    val serializer: Serializer = SparkEnv.get.serializer,
    val keyOrdering: Option[Ordering[K]] = None,
    val aggregator: Option[Aggregator[K, V, C]] = None, // mapSideCombine
    val mapSideCombine: Boolean = false)
  extends Dependency[Product2[K, V]] {
  val shuffleId: Int = _rdd.context.newShuffleId()
  val shuffleHandle: ShuffleHandle = ... // SortShuffleManager 生成
}
4.2 ShuffleDependency 的五个关键属性
| 属性 | 说明 | 影响 |
|---|---|---|
| partitioner | HashPartitioner / RangePartitioner | 决定数据如何分布到下游 Partition |
| serializer | Kryo / Java | 序列化 Shuffle 中间数据 |
| keyOrdering | 排序器 | sortByKey 必须指定 |
| aggregator | 聚合器 | reduceByKey 的 mapSideCombine |
| mapSideCombine | 是否 Map 端预聚合 | reduceByKey vs groupByKey 的关键区别 |
4.3 reduceByKey vs groupByKey
// ❌ groupByKey: mapSideCombine=false — 全量数据传输
rdd.groupByKey()  // Shuffle 传输所有 KV 对

// ✅ reduceByKey: mapSideCombine=true — Map 端预聚合
rdd.reduceByKey(_ + _) // Shuffle 前先在 Map 端合并性能差异:reduceByKey 比 groupByKey 减少 90%+ 的 Shuffle 数据量(取决于 Key 的重复率)。
五、依赖类型决定 Stage 边界
// 源码:DAGScheduler.scala
private def getOrCreateParentStages(rdd: RDD[_], firstJobId: Int): List[Stage] = {
  rdd.dependencies.flatMap {
    case shufDep: ShuffleDependency[_, _, _] =>
      // 🔥 遇到 Shuffle → 创建 ShuffleMapStage → Stage 边界
      getOrCreateShuffleMapStage(shufDep, firstJobId) :: Nil
    case _: NarrowDependency[_] =>
      Nil  // Narrow → 同 Stage, 不切分
  }.toList
}规则:遇到 ShuffleDependency 即切分 Stage,NarrowDependency 全部在同一 Stage 内 Pipeline 执行。
六、容错策略差异
| 维度 | Narrow | Wide |
|---|---|---|
| 容错范围 | 只重算丢失 Partition | 重算整个 Stage(因为上游数据需要重新 Shuffle) |
| 血缘链 | 短(Pipeline 内) | 长(跨 Stage) |
| 恢复成本 | 低 | 高(Shuffle 重复 I/O) |
| Checkpoint | 通常不需要 | 强烈建议在 Shuffle 后 Checkpoint |
七、性能优化建议
# 1. 用 reduceByKey 代替 groupByKey(开启 mapSideCombine)
# 2. 用 Kryo 序列化减少 Shuffle 数据量
--conf spark.serializer=org.apache.spark.serializer.KryoSerializer

# 3. 调大 Shuffle 分区数避免数据倾斜
--conf spark.sql.shuffle.partitions=400

# 4. 启用 Shuffle 文件合并
--conf spark.shuffle.consolidateFiles=true
八、总结
| 要点 | 总结 |
|---|---|
| NarrowDependency | 1→1 / Range / Prune, 同 Stage Pipeline, 容错轻 |
| ShuffleDependency | 多→多, Stage 边界, Shuffle I/O 重, 容错贵 |
| Stage 切分 | 遇 ShuffleDependency 即切分 |
| 优化核心 | 减少 Shuffle = 减少 Stage = 提升性能 |
金句:Narrow 是团队内部的接力赛(一棒接一棒,全在一个 Stage),Wide 是部门之间的邮件沟通(必须写好 Shuffle 文件,下一个 Stage 再来读)。