
SparkStreaming 之 Direct 模式 API 代码实现
摘要:上一篇把 Direct 模式的原理讲清楚了,这篇落到代码——从 Maven 依赖、KafkaParams 配置、createDirectStream 调用,到三种 ConsumerStrategies 和 LocationStrategies 的写法,再到 offset 的手动管理,给出一套能直接抄来跑的生产代码。
关键词:Spark Streaming, Direct 模式, createDirectStream, KafkaParams, offset 管理, commitAsync
一、先对齐依赖版本
Direct 模式(Kafka 0.10 API)用的依赖是 spark-streaming-kafka-0-10,不是老的 -0-8。版本必须和你的 Spark 版本严格对齐,否则运行时抛 NoSuchMethodError 这类二进制兼容问题。
// build.sbt
libraryDependencies += "org.apache.spark" %% "spark-streaming-kafka-0-10" % "2.4.0"<!-- pom.xml -->
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming-kafka-0-10_2.11</artifactId>
<version>2.4.0</version>
</dependency>二、KafkaParams 配置
Direct 模式通过一个 Map[String, Object] 传 Kafka 消费参数。几个必填的:
import org.apache.kafka.common.serialization.StringDeserializer

val kafkaParams = Map[String, Object](
  "bootstrap.servers" -> "broker1:9092,broker2:9092",
  "key.deserializer" -> classOf[StringDeserializer],
  "value.deserializer" -> classOf[StringDeserializer],
  "group.id" -> "streaming-app",
  "auto.offset.reset" -> "latest",          // 首次消费从最新开始
  "enable.auto.commit" -> (false: java.lang.Boolean)   // 关键:必须 false
)
enable.auto.commit 必须设 false。上一篇讲过,Direct 模式的 offset 由 Spark 自己管,如果这里不关掉 Kafka 的自动提交,会有两套 offset 在打架,exactly-once 就失效了。注意 Scala 里要显式写成 (false: java.lang.Boolean),否则会被当成 Boolean 装箱类型对不上。
三、createDirectStream 调用
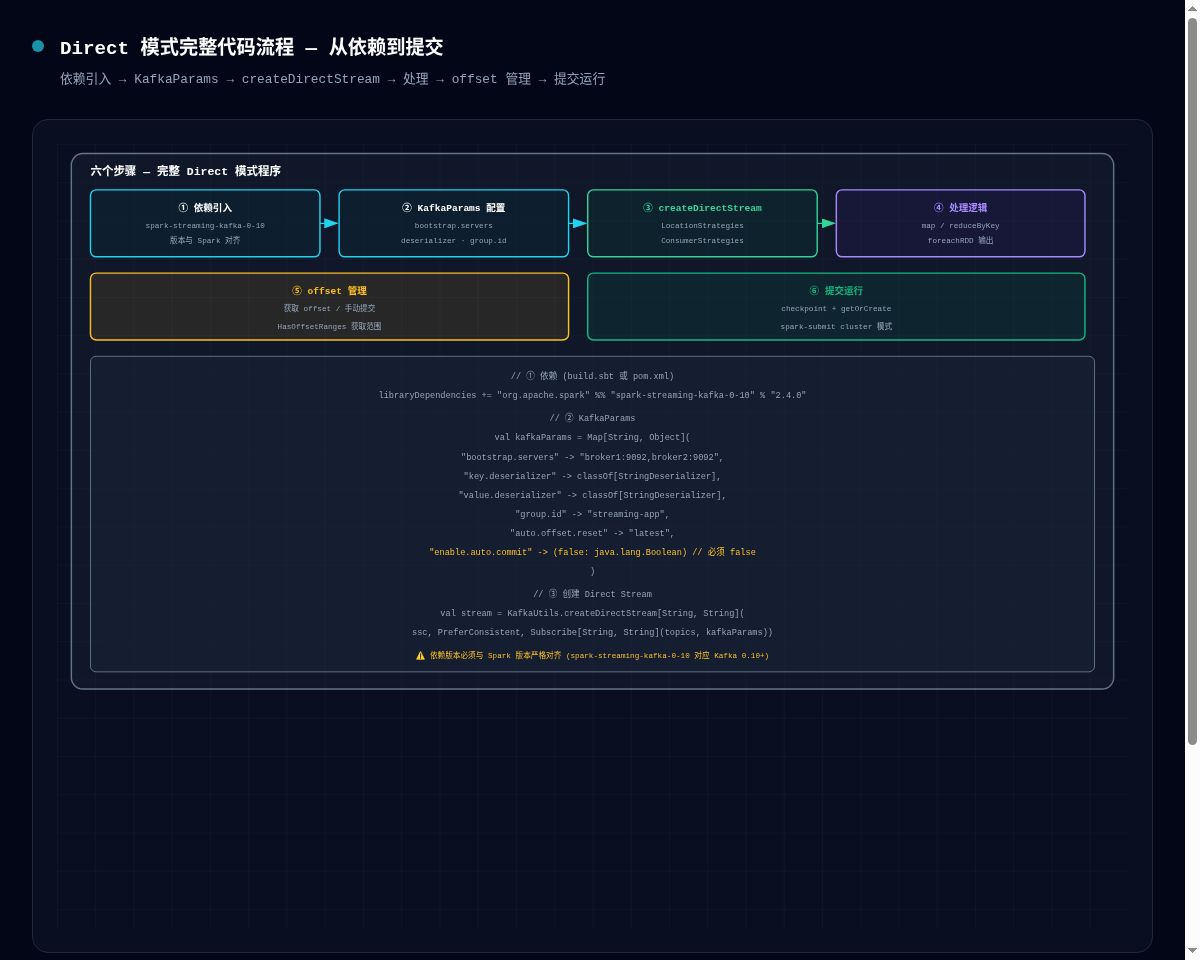
import org.apache.spark.streaming.kafka010._

val stream = KafkaUtils.createDirectStream[String, String](
  ssc,
  PreferConsistent,                                    // 位置策略
  Subscribe[String, String](Array("topic-a"), kafkaParams)  // 订阅策略
)两个参数分别是位置策略(数据放哪算)和订阅策略(订阅哪些分区)。
四、三种 ConsumerStrategies
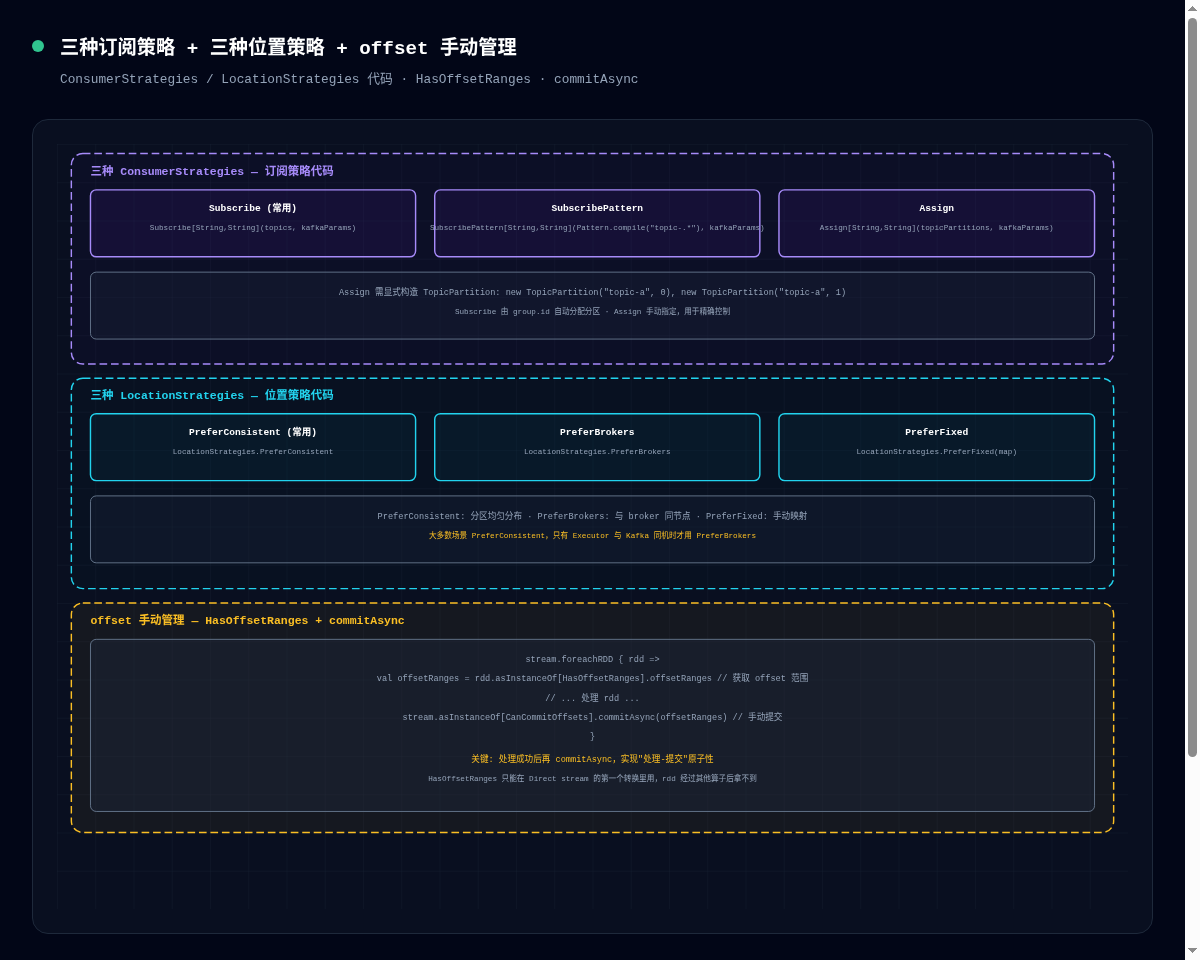
订阅策略决定"消费哪些 topic/分区":
// 1. Subscribe:订阅指定 topic 列表(最常用)
Subscribe[String, String](Array("topic-a", "topic-b"), kafkaParams)

// 2. SubscribePattern:正则匹配 topic
SubscribePattern[String, String](
  java.util.regex.Pattern.compile("topic-.*"), kafkaParams)

// 3. Assign:显式指定具体分区
Assign[String, String](
  Array(new TopicPartition("topic-a", 0), new TopicPartition("topic-a", 1)),
  kafkaParams)
Subscribe 由 group.id 自动分配分区,是最常见的用法;Assign 手动指定分区,用在需要精确控制消费范围的场景(比如回放某个分区的一段 offset)。
五、三种 LocationStrategies
位置策略决定"分区数据放到哪个 Executor 处理":
// 1. PreferConsistent:分区均匀分布到所有 Executor(最常用)
LocationStrategies.PreferConsistent

// 2. PreferBrokers:Executor 和 Kafka broker 同节点时用
LocationStrategies.PreferBrokers

// 3. PreferFixed:手动指定分区到主机的映射
LocationStrategies.PreferFixed(
  Map(new TopicPartition("topic-a", 0) -> "host1:9092"))
绝大多数场景用 PreferConsistent。只有当你把 Executor 部署在 Kafka broker 同一台机器上时,PreferBrokers 才有意义(能走本地读)。PreferFixed 一般用不上。
六、offset 手动管理
这是 Direct 模式代码里最容易写错的部分。要手动提交 offset,得先拿到每个 RDD 对应的 offset 范围:
import org.apache.spark.streaming.kafka010._

stream.foreachRDD { rdd =>
  // 关键:只能在 Direct stream 的第一个转换里拿 offsetRanges
  val offsetRanges = rdd.asInstanceOf[HasOffsetRanges].offsetRanges

  // 处理 rdd ...
  val result = rdd.map(...).reduceByKey(...)

  // 处理成功后再提交 offset
  stream.asInstanceOf[CanCommitOffsets].commitAsync(offsetRanges)
}
两个坑:
offsetRanges只能在第一个转换里取。HasOffsetRanges这个类型只在 Direct stream 生成的原始 RDD 上存在,一旦你rdd.map(...)之后,类型就丢了,再取会抛ClassCastException。所以要在 foreachRDD 一进来就把 offsetRanges 抓出来。- 处理成功再提交。
commitAsync要放在处理逻辑之后,这样才能实现"处理—提交"的原子性——处理失败就不会提交 offset,重算时从原位置重拉,这正是 exactly-once 的实现方式。
七、完整代码串起来
import org.apache.spark.streaming.{Seconds, StreamingContext}
import org.apache.spark.streaming.kafka010._
import org.apache.kafka.common.serialization.StringDeserializer

def createContext(): StreamingContext = {
  val ssc = new StreamingContext(conf, Seconds(5))
  ssc.checkpoint("hdfs://namenode:8020/checkpoint/app")

  val kafkaParams = Map[String, Object](
    "bootstrap.servers" -> "broker1:9092,broker2:9092",
    "key.deserializer" -> classOf[StringDeserializer],
    "value.deserializer" -> classOf[StringDeserializer],
    "group.id" -> "streaming-app",
    "auto.offset.reset" -> "latest",
    "enable.auto.commit" -> (false: java.lang.Boolean)
  )

  val stream = KafkaUtils.createDirectStream[String, String](
    ssc, PreferConsistent,
    Subscribe[String, String](Array("topic-a"), kafkaParams))

  stream.foreachRDD { rdd =>
    val offsetRanges = rdd.asInstanceOf[HasOffsetRanges].offsetRanges
    rdd.map(_.value).foreachPartition { iter => /* 业务处理 */ }
    stream.asInstanceOf[CanCommitOffsets].commitAsync(offsetRanges)
  }

  ssc
}

val ssc = StreamingContext.getOrCreate(checkpointPath, createContext _)
ssc.start(); ssc.awaitTermination()
提交时用 cluster 模式 + supervise(配合上一篇 Driver HA 的内容):
spark-submit --master yarn --deploy-mode cluster --supervise \
  --class com.example.DirectStreamApp app.jar
八、总结
- 依赖用
spark-streaming-kafka-0-10,版本与 Spark 严格对齐。 - KafkaParams 里
enable.auto.commit必须设 false,且 Scala 里要写(false: java.lang.Boolean)。 - ConsumerStrategies 常用 Subscribe,LocationStrategies 常用 PreferConsistent。
- offset 手动管理的关键:
offsetRanges只能在第一个转换里取,处理成功后再commitAsync。 - 提交侧 cluster 模式 + supervise,配合 checkpoint 实现完整的高可用。
作者:大数据技术实践者
博客:blog.starzy.cn
GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践